Claude Fable 5.1 и Mythos 5.1: что нового в моделях Anthropic
Anthropic представила Claude Fable 5.1 и Claude Mythos 5.1. По сути это одна и та же модель, только с разными ограничениями. Fable 5.1 доступна всем, а Mythos 5.1 выдают только проверенным специалистам по кибербезопасности и наукам о жизни. Fable 5.1 сильнее Fable 5 в коде, науке и офисной работе, реже блокирует безобидные вопросы и на обычных задачах обходится примерно на 25% дешевле, хотя цена за токен осталась прежней. Ниже пересказываем анонс по-русски: цифры сведены в графики, отзывы компаний, тестировавших модель заранее, выбраны самые показательные.
Главное за минуту
- Две версии одной модели. Fable 5.1 открыта всем. Mythos 5.1 с ослабленными ограничениями по кибербезопасности и биологии пока доступна только проверенным организациям в США.
- Рекорды в коде и науке. Terminal-Bench 4.0: 55,8% (у Mythos 5.1 60,9%), у Fable 5 было 42%. В научной работе в терминале результат вырос вдвое: 52,6% против 24,7%.
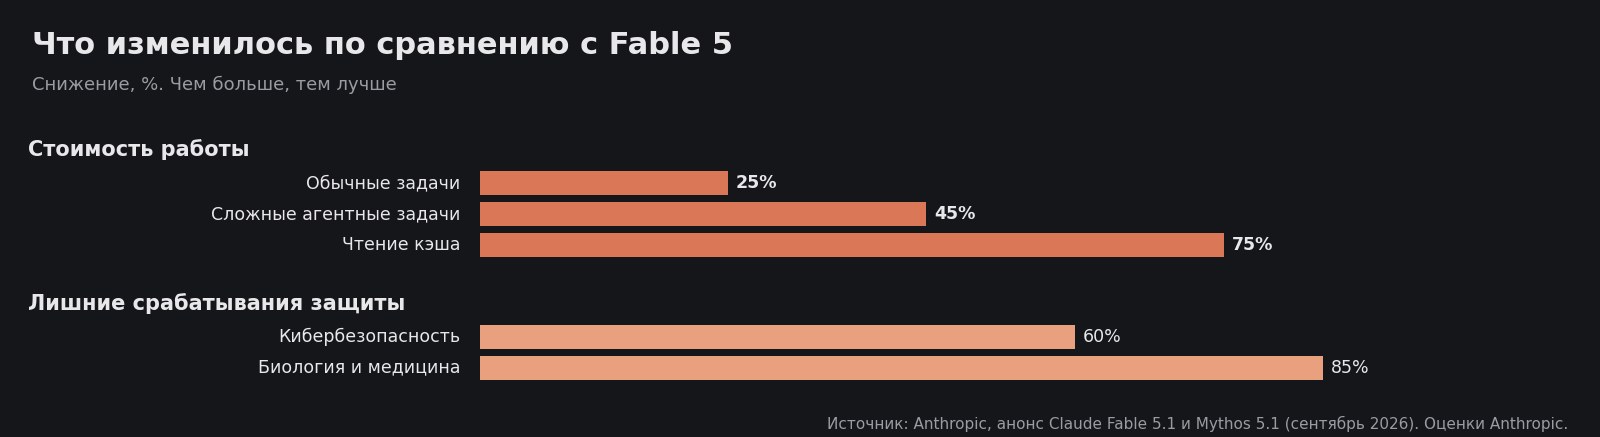
- Дешевле при той же цене. Прайс прежний, 10 $ за миллион токенов на входе и 50 $ на выходе. Но чтение кэша подешевело на 75%, поэтому обычная работа выходит примерно на 25% дешевле, а долгие агентные задачи до 45% дешевле.
- Меньше ложных отказов. В кибербезопасности защита вмешивается примерно на 60% реже, в вопросах по биологии и медицине на 85% реже.
- Научные результаты. Модель спроектировала белки, которые связываются с мишенями почти в половине случаев, построила подробную карту рельефа Венеры и ускорила семь моделей для биологии до 2,5 раза.
Чем Fable 5.1 отличается от Mythos 5.1
По устройству Fable 5.1 и Mythos 5.1 не различаются. Разница только в том, насколько строго модель ограничивают.
У Fable 5.1 работает полный набор защитных фильтров. Часть запросов по кибербезопасности (тесты на проникновение, создание эксплойтов, поиск уязвимостей в скомпилированных программах) и по исследованиям в биологии она не выполняет сама: такие задачи передаются моделям Opus. Для обычной работы, от кода до договоров, это незаметно.
Mythos 5.1 отвечает на такие запросы свободнее. Поэтому её выдают только через две программы проверенного доступа:
- Cyber Verification Program — для специалистов по защите информации;
- Life Sciences Verification Program — для учёных-биологов, создана вместе с правительством США.
Пока Mythos 5.1 доступна лишь ряду американских организаций. Anthropic обещает расширить круг партнёров, в том числе за пределами США, но сроков не называет. Кроме того, на Mythos 5.1 перевели Claude Security — продукт, который ищет уязвимости в коде и предлагает исправления.
Разница в бенчмарках между версиями объясняется только фильтрами. На Terminal-Bench 4.0 Mythos 5.1 набирает 60,9%, а Fable 5.1 55,8%: на части задач старые, менее точные фильтры по кибербезопасности вмешивались в работу Fable. С обновлёнными фильтрами Anthropic ожидает, что разрыв станет гораздо меньше.
Бенчмарки Claude Fable 5.1: код, наука, офисная работа
Anthropic сравнила Fable 5.1 со своими Fable 5 и Opus 5 и с GPT-5.6 Sol от OpenAI. Новая модель впереди во всех тестах из анонса.
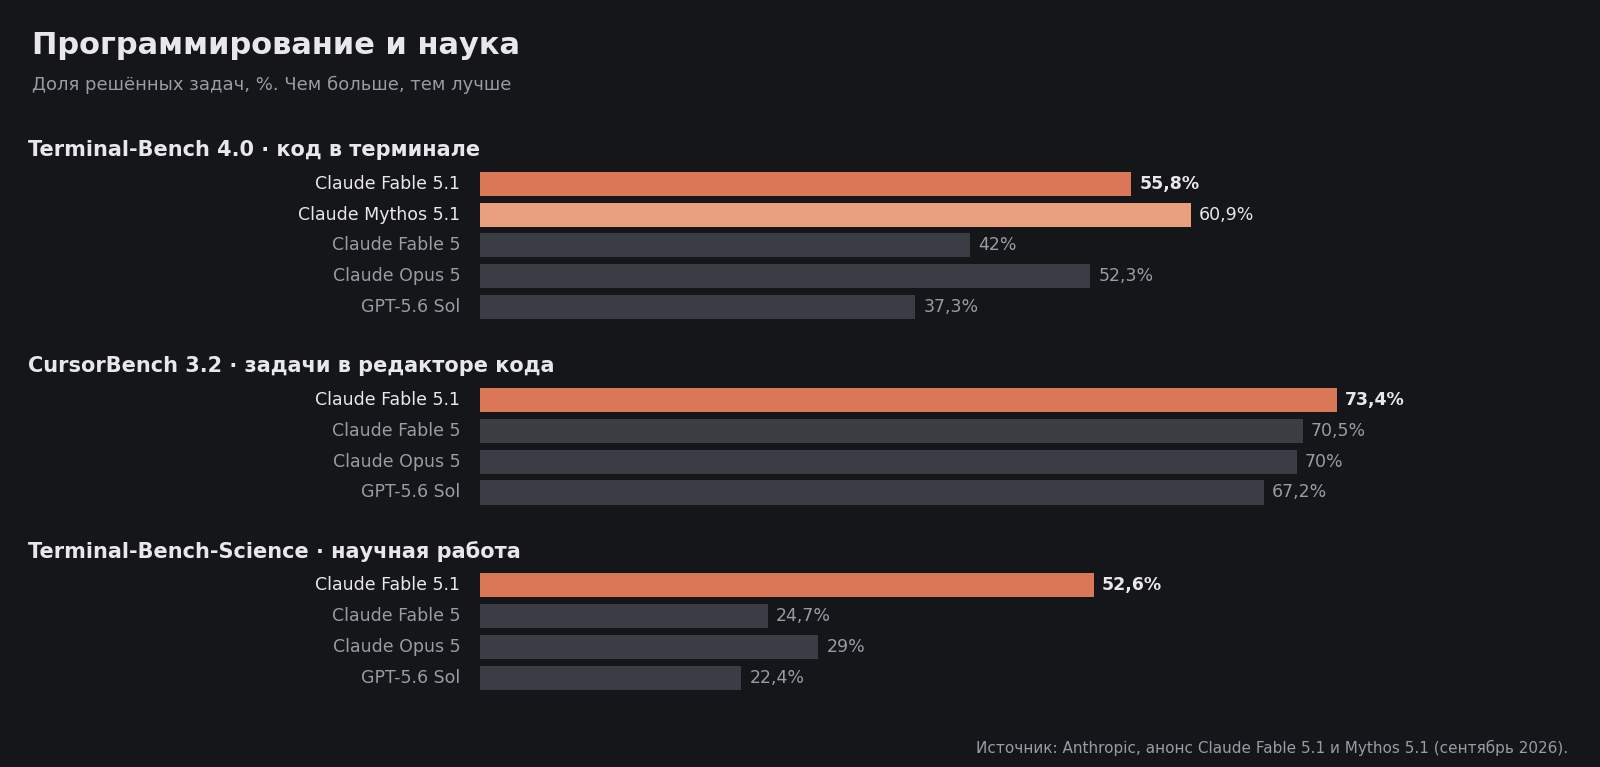
Самый большой скачок — в научной работе. Terminal-Bench-Science проверяет полный цикл исследования в терминале: разобрать данные, запустить расчёт, проверить результат. Fable 5.1 решает 52,6% задач, вдвое больше, чем Fable 5 (24,7%) и GPT-5.6 Sol (22,4%).
В программировании рост тоже заметный. На CursorBench, где задачи похожи на повседневную работу разработчика в редакторе кода, у Fable 5.1 73,4%. Anthropic отдельно отмечает, что модель не срезает углы ради быстрого результата и ищет настоящую причину ошибки, а не маскирует симптом.
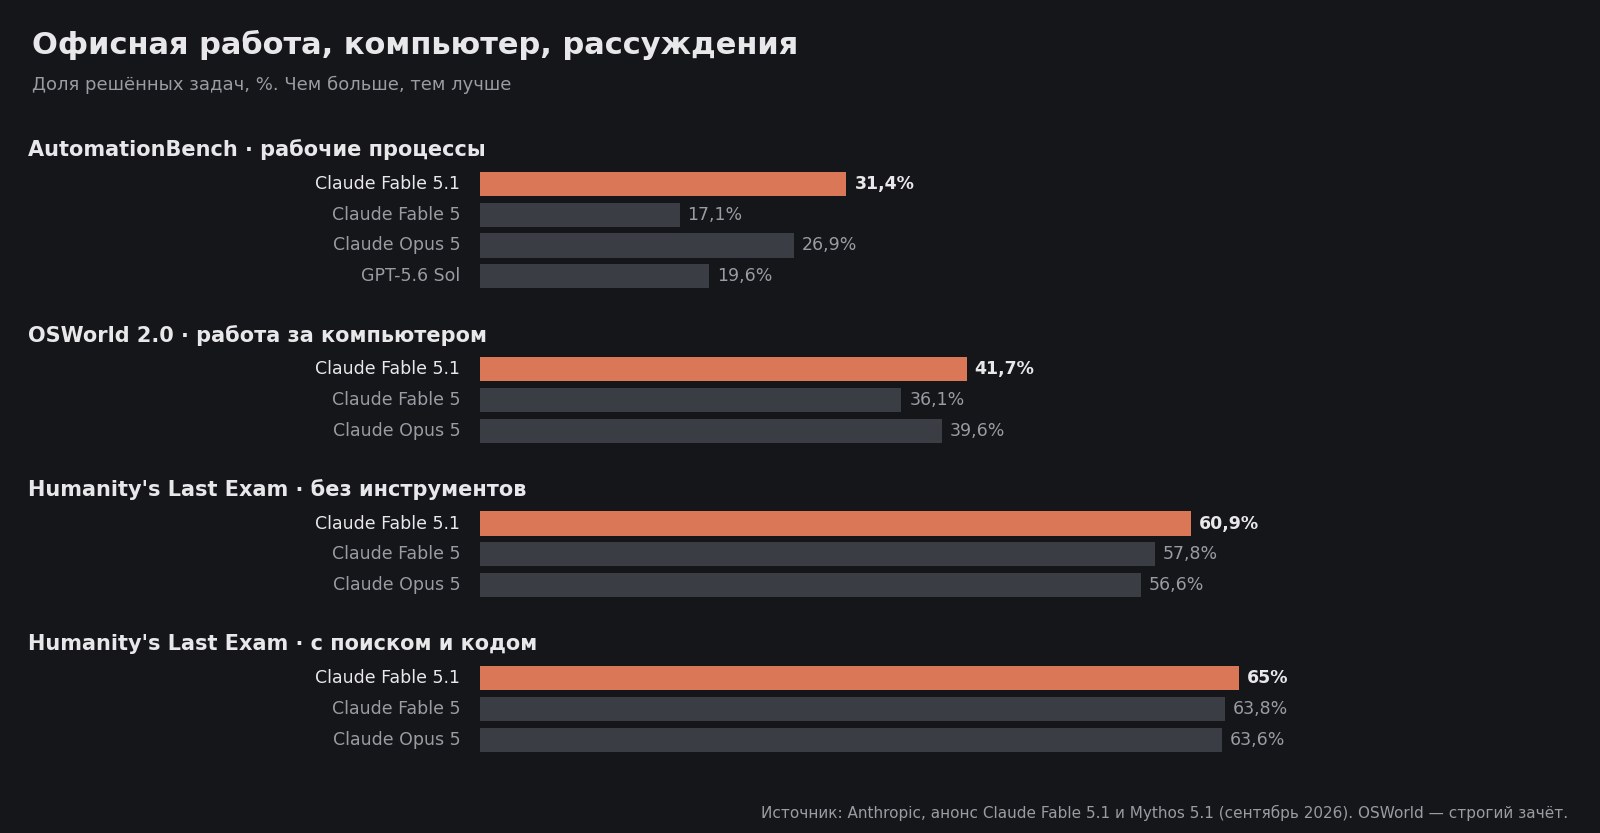
В автоматизации рабочих процессов (AutomationBench) Fable 5.1 почти вдвое обходит Fable 5: 31,4% против 17,1%. На OSWorld 2.0, где модель сама работает в операционной системе, у неё 41,7% по строгому зачёту и 77,9% по частичному. В Humanity's Last Exam, наборе самых трудных вопросов из разных наук, — 60,9% без инструментов и 65% с поиском и кодом.
Все результаты в одной таблице:
| Тест | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science (научная работа) | 52,6% | 24,7% | 29,0% | 22,4% |
| Terminal-Bench 4.0 (код в терминале) | 55,8% (Mythos 60,9%) | 42,0% | 52,3% | 37,3% |
| CursorBench 3.2 (код в редакторе) | 73,4% | 70,5% | 70,0% | 67,2% |
| GDPval-AA v2 (офисные задачи, рейтинг) | 1853 | 1723 | 1824 | 1711 |
| AutomationBench (рабочие процессы) | 31,4% | 17,1% | 26,9% | 19,6% |
| OSWorld 2.0, строгий / частичный зачёт | 41,7% / 77,9% | 36,1% / 72,9% | 39,6% / 75,4% | — |
| Humanity's Last Exam, без / с инструментами | 60,9% / 65,0% | 57,8% / 63,8% | 56,6% / 63,6% | — |
Ещё одна деталь из анонса: Fable 5.1 можно запускать с разной глубиной рассуждений. На низком и среднем уровне она выдаёт результат не хуже Fable 5, но заметно дешевле. Тесты шли с включёнными боевыми фильтрами. Там, где фильтры вмешивались, задачу засчитывали как проваленную, так что реальные цифры могут быть чуть выше.
Что говорят компании, которые тестировали модель
Доступ к модели заранее получили больше двадцати компаний. Вот несколько отзывов:
- Millennium (инвестфонд): в их системе был сбой, который случался примерно раз на миллион запусков, и четыре-пять лет никто не мог найти причину. Fable 5.1 первой её нашла: разобрала стороннюю библиотеку, сопоставила с дампом памяти и нашла ошибку в этой библиотеке.
- Every: «Интеллект уровня Fable, цена уровня Opus, скорость уровня Sonnet». По их замерам модель вдвое быстрее Opus 5 и тратит вдвое меньше токенов.
- Rakuten: Fable 5.1 проверила клиническое исследование, которое до этого одобрили три другие передовые модели, и нашла пропуск, которого не заметил никто. А потом предложила новую гипотезу, и данные, которые команда считала бесполезными, стали новым направлением исследования.
- Ramp: модель проработала без присмотра 38 часов над задачей машинного обучения: нашла ошибку в разметке прошлого результата, исправила её, запустила шесть экспериментов на ночь и вернулась с результатом и планом дальнейших шагов.
- Canva: больше всего выделяется текст. Он понятнее, содержательнее и точнее следует инструкциям по стилю. В слепых сравнениях с Fable 5 выигрывала новая модель.
- Crosby (правка договоров): на их тесте результат вырос с 47,9 до 57 баллов, а качество первой версии правок удвоилось. Правки стали короче и аккуратнее.
- Hebbia: лучшие презентации из всех проверенных моделей и лучшая точность фактов по финансовым документам. Первая модель, которая ответила на все части сложного составного вопроса.
- Shopify: модель спокойно ведёт длинную работу без присмотра: сама ведёт записи, меняет приоритеты по ходу и продолжает с того места, где остановилась.
Общая линия отзывов — длинные самостоятельные задачи. Прежние модели на долгой дистанции теряли нить или начинали писать путано, а Fable 5.1 держит цель и остаётся понятной.
Научные результаты: белки, карта Венеры, ускорение моделей
Anthropic называет эти результаты «ранним взглядом» на то, как ИИ будет участвовать в научных открытиях.
Проектирование белков. Многие лекарства работают так: молекула прочно цепляется за мишень в организме. Mythos 5.1 получила открытые инструменты для дизайна белков, а её разработки проверили в двух независимых лабораториях. На трёх мишенях связывание оказалось в 10 раз прочнее, чем у лучших работ на конкурсах Adaptyv Bio. Главное — доля удачных дизайнов: почти 50% на 12 мишенях. Обычно в этой области удачны 10–15% вариантов.
Карта Венеры. Fable 5.1 обучила нейросеть и построила новую карту высот для трети поверхности Венеры по радарным снимкам миссии NASA «Магеллан» тридцатилетней давности. Детали видны до 2–3 км вместо прежних 10–20, высоты на 25% точнее. Карту выложили в открытый доступ к будущим миссиям NASA VERITAS и ESA EnVision.
Ускорение моделей для биологии. Биологи гоняют специализированные нейросети на видеокартах тысячи раз за эксперимент, поэтому скорость здесь напрямую тормозит исследования. Mythos 5.1 переписала вычисления для семи открытых моделей и ускорила их до 2,5 раза без изменения результатов. На анализах целого генома это снижает затраты на вычисления на 30–60%. Такая работа обычно занимает у команды инженеров недели, модель справилась за несколько дней.
Безопасность: меньше ложных отказов и защита данных
Перед выпуском Anthropic проверила модели на риски в нескольких областях:
- Биологические и химические риски. Mythos 5.1 сильнее Mythos 5, но до следующего уровня риска по внутренней шкале Anthropic не дотягивает. Ограничения оставили прежними.
- Кибербезопасность. У Mythos 5.1 самые сильные навыки взлома среди выпущенных моделей Anthropic, но она всё ещё в нижней категории риска. Фильтры Fable 5.1 проверяли сама Anthropic и две внешние организации. Критического обхода не нашли.
- Поведение. Модель реже Mythos 5 пытается выйти за пределы тестовой среды, реже оправдывает свои действия тем, что «это всего лишь проверка», и реже нарушает явные запреты ради цели. При этом Anthropic признаёт, что иногда модель всё ещё обходит подтверждения и автоматические проверки.
Для пользователей важнее другое: фильтры стали точнее. На простые вопросы по биологии и медицине защита срабатывает на 85% реже, чем при запуске Fable 5. В программировании вмешательств примерно на 60% меньше. Кроме того, Fable 5.1 теперь разрешено искать уязвимости в программах ради защиты (но не писать эксплойты).
Что ещё появилось:
- Enterprise Frontier Safeguards (EFS) — режим для корпоративных клиентов. Данные хранятся в облаке самого клиента, а не у Anthropic, и защита от злоупотреблений при этом продолжает работать. Режим включат поэтапно с осени.
- Защита от дистилляции. Так называют «выкачивание» способностей модели через тысячи фейковых аккаунтов. Новые API-аккаунты больше не могут подменять прошлые ответы Claude в переписке с сохранением его рассуждений, а это был распространённый способ такой кражи.
- Водяной знак по требованию закона ЕС об ИИ. В тексты моделей, вышедших после 2 августа 2026 года, добавлена невидимая статистическая метка. На качество ответа она не влияет и ничего не сообщает о пользователе. Проверить метку могут только регуляторы, СМИ, исследователи и компании, которым это нужно по закону.
Цена: почему Fable 5.1 дешевле Fable 5 при том же прайсе
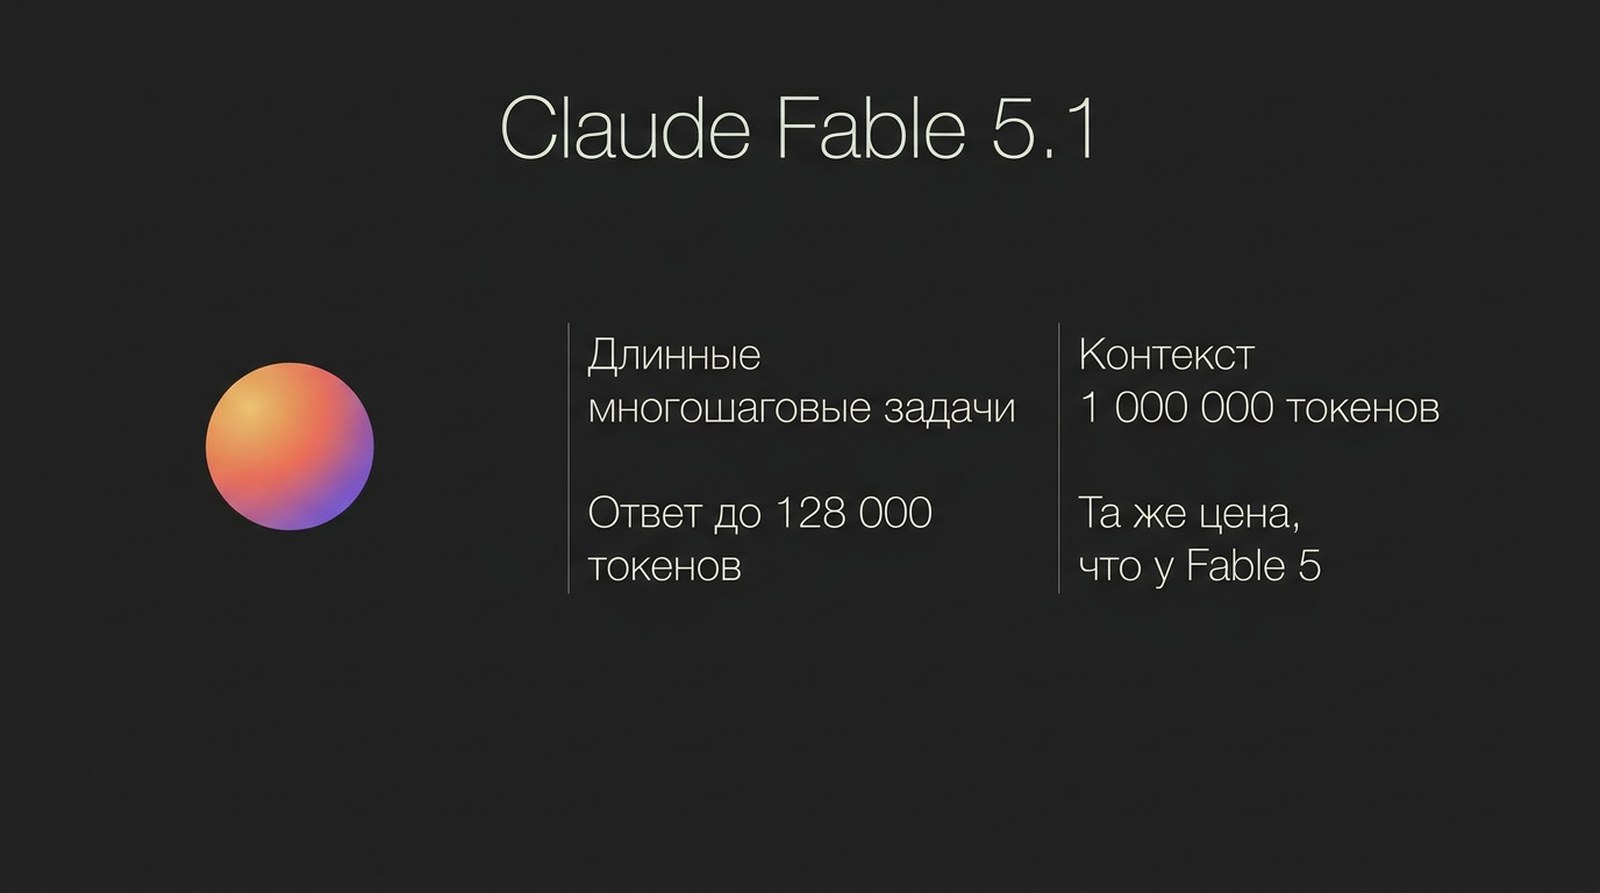
Прайс за токены не изменился: 10 $ за миллион токенов на входе и 50 $ на выходе. Подешевело только чтение кэша — в 4 раза, до 0,25 $ за миллион токенов.
В долгом разговоре или многошаговой задаче модель на каждом шаге заново читает всю предыдущую переписку, документы и результаты инструментов. Если всё это уже обработано раньше, оно читается из кэша. У агентных задач именно кэш составляет большую часть счёта. По расчёту Anthropic на реальной нагрузке августа 2026 года:
- обычная работа выходит примерно на 25% дешевле, чем с Fable 5;
- сложные задачи с кодом и инструментами — до 45% дешевле.
| Параметр | Claude Fable 5.1 |
|---|---|
| Выход | сентябрь 2026 |
| Контекст | 1 млн токенов |
| Длина ответа | до 128 000 токенов |
| Вход | текст, изображения, файлы |
| Цена Anthropic | 10 $ / 50 $ за 1 млн токенов (вход / выход) |
| Чтение кэша | 0,25 $ за 1 млн токенов (было 1 $) |
| Ориентир в чате | ~2 ₽ / ~10 ₽ за 1000 токенов (вход / выход) |
Fable 5.1 или GPT-6 Astra: что выбрать
Две флагманские модели вышли с разницей в два дня и стоят одинаково, 10 $ / 50 $ за миллион токенов. По цифрам из анонсов:
| Тест | Claude Fable 5.1 | GPT-6 Astra |
|---|---|---|
| Terminal-Bench 4.0 (код) | 55,8% | 57,9% |
| Terminal-Bench-Science (наука) | 52,6% | 64,6% |
| FrontierMath Tier 4 (математика) | 87,8% | 97,6% |
| BenchCAD (3D-модели по чертежам) | 84,3% | 95,9% |
На тестах GPT-6 Astra впереди, особенно в математике и науке. У Fable 5.1 другие сильные стороны, о которых говорят тестировщики: текст, правка договоров и документов, длинная самостоятельная работа без потери нити, аккуратный разбор причин ошибок в коде. Лучший способ выбрать — дать обеим моделям одну и ту же свою задачу и сравнить.
Если задача не самая сложная, выгоднее модели на ступень ниже. Claude Opus 5.5 стоит в 2,5 раза дешевле Fable 5.1 и для большинства текстов и кода её хватает. Цены всех моделей за 1000 токенов собраны в таблице моделей для чата.
Как попробовать Claude Fable 5.1 в России
Fable 5.1 уже в каталоге tenzor и работает из России без VPN, на русском, с оплатой рублёвой картой. Прежнюю Fable 5 из выбора убрали: новая стоит столько же и отвечает лучше. Старые чаты с Fable 5 открываются как раньше. Mythos 5.1 в каталоге нет: у Anthropic она доступна только участникам закрытых программ.
- Откройте чат и выберите Claude Fable 5.1 в списке моделей над полем ввода.
- Дайте ей настоящую задачу целиком: проект с кодом, пачку документов, таблицу для разбора.
- Модель сама вызывает поиск в интернете, считает таблицы, готовит файлы Word и Excel и собирает живые страницы.
Подробнее о модели читайте на странице Claude Fable 5.1, обзор всей линейки Anthropic есть на странице Claude.
Чем Claude Fable 5.1 отличается от Claude Mythos 5.1?+
Это одна и та же модель с разным уровнем ограничений. Fable 5.1 доступна всем и не выполняет часть задач по кибербезопасности и биологическим исследованиям. Mythos 5.1 отвечает на них свободнее, поэтому её выдают только проверенным специалистам через программы Anthropic.
Можно ли пользоваться Claude Mythos 5.1 в России?+
Нет. Сейчас Mythos 5.1 доступна только ряду организаций в США через программы проверенного доступа. Всем остальным доступна Fable 5.1 — та же модель с обычными ограничениями.
Fable 5.1 дороже Fable 5?+
Нет. Цена за токены та же: 10 $ за миллион на входе и 50 $ на выходе. А чтение кэша подешевело на 75%, поэтому обычная работа выходит примерно на 25% дешевле, а долгие агентные задачи до 45% дешевле.
Что лучше, Claude Fable 5.1 или GPT-6 Astra?+
По тестам разработчиков Astra впереди в математике, науке и коде, а сильные стороны Fable 5.1 — текст, работа с документами и длинные самостоятельные задачи. Стоят они одинаково, поэтому надёжнее проверить обе на своей задаче.
Можно ли попробовать Claude Fable 5.1 бесплатно?+
Fable 5.1 — одна из самых дорогих моделей. Стартовых кредитов при регистрации хватит, чтобы познакомиться с сервисом на более простых моделях, а для работы с Fable 5.1 нужно пополнить баланс.
Попробуйте Claude Fable 5.1 в чате
Новая модель Anthropic на русском — без VPN и зарубежных карт.
Открыть чат