Тест на закрытом коде реальных компаний: лучшая модель решает 39% задач
Когда выходит новая модель, в релизе обязательно есть цифра вроде «решает 74% задач по программированию». Цифра честная, но берётся она с публичных тестов — открытых репозиториев на GitHub, где и сам код, и обсуждения, и готовые решения давно лежат в интернете.
Лаборатория Specific Labs собрала бенчмарк Real-SWE, где всё наоборот: задачи взяты из закрытых рабочих репозиториев реальных компаний. Результаты получились вдвое скромнее.
Что именно проверяли
Компании передали лаборатории доступ к своему боевому коду. Задачи — те, над которыми работают их собственные инженеры: посчитать налог, поправить биллинг, перенести клиентов между сервисами. Дело не в сложности алгоритма, а в контексте.
Три вещи отличают такие задачи от учебных:
- Код нигде не опубликован. Модель не могла видеть ни его, ни готовых решений при обучении.
- У ошибки есть цена. Неправильно посчитанный счёт — это не упавший тест, а деньги и недовольные клиенты.
- У каждой компании свои порядки. Собственные соглашения об именовании, устоявшаяся архитектура, исторические причины писать именно так. Правка должна лечь в этот контекст.
Результаты
| Модель | Инструмент | Решено задач |
|---|---|---|
| Claude Fable 5.1 | Claude Code | 38,8% |
| GPT-6 Astra | Codex CLI | 33,8% |
| Gemini 3.8 Flash | Gemini CLI | 31,2% |
| GLM 5.3 | Claude Code | 28,8% |
| Grok 4.6 | Grok Build | 23,8% |
| Muse Spark 1.3 | Muse Code | 23,8% |
| Kimi K3 | Kimi Code | 18,8% |
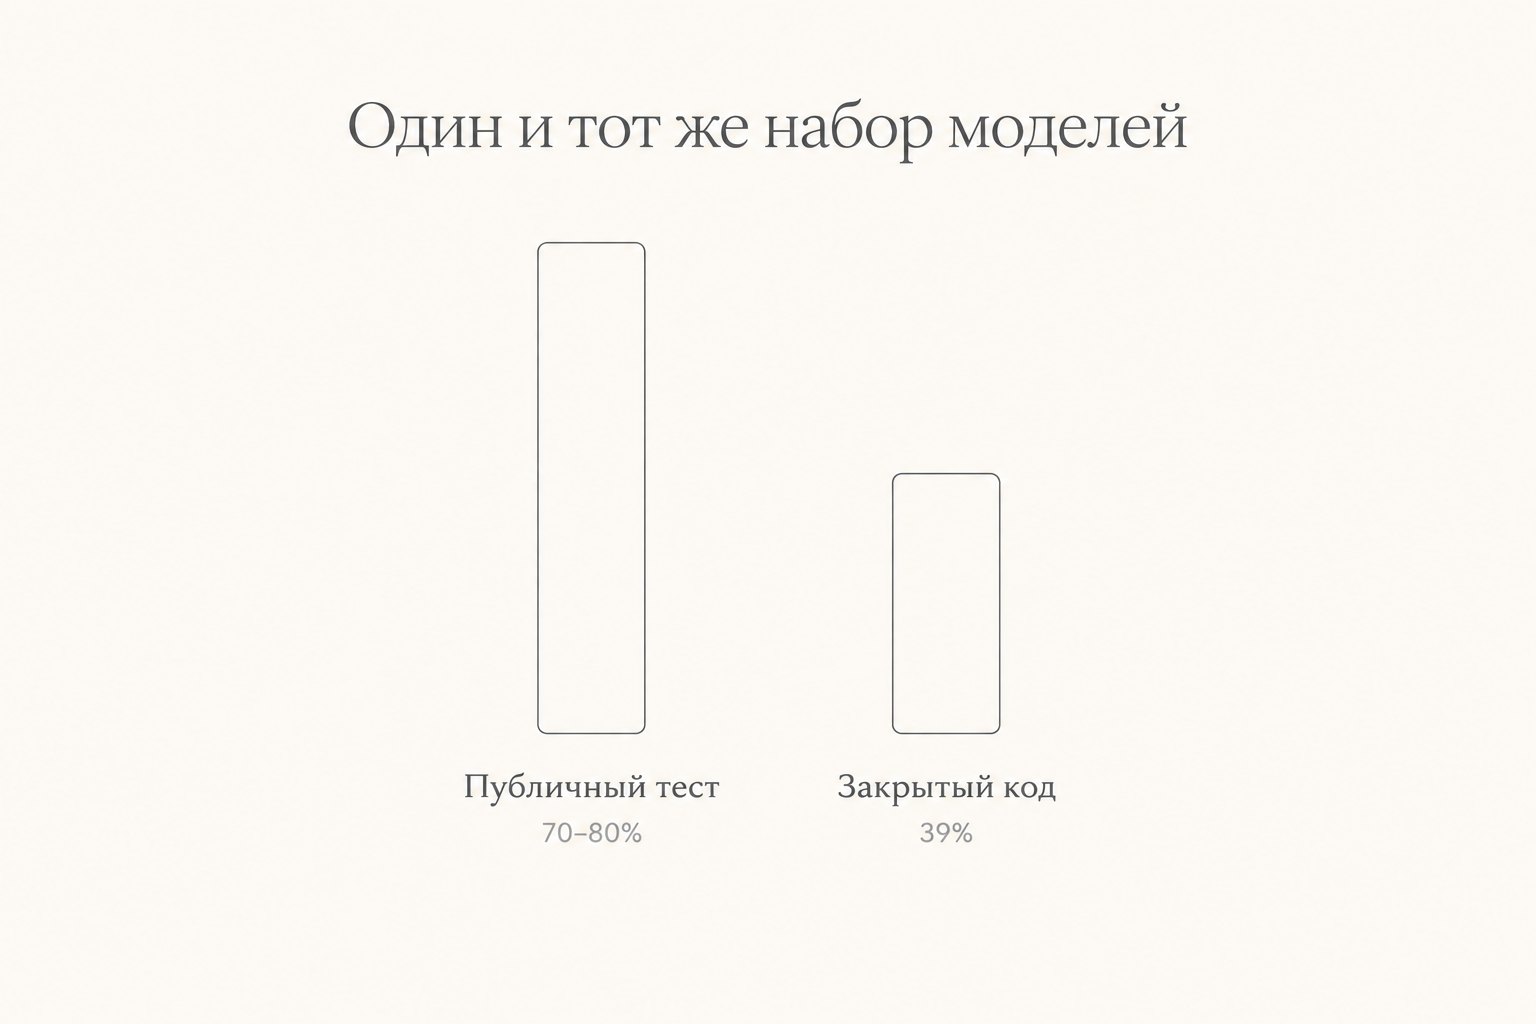
Порядок лидеров примерно совпадает с привычными рейтингами, а вот абсолютные значения — нет. На публичных тестах те же модели показывают 70–80%. Здесь лучший результат не дотягивает и до сорока.
Почему разрыв такой большой
Первая причина очевидная: публичный код мог попасть в обучение. Не обязательно дословно — достаточно, что модель видела тысячи похожих задач с обсуждениями и решениями. На незнакомом проекте эта фора исчезает.
Вторая причина интереснее. В учебной задаче условие сформулировано целиком: вот баг, вот тест, который должен позеленеть. В рабочей задаче половина условия не записана нигде. Почему тут сделано именно так. Какие места трогать нельзя. Что сломается в соседнем сервисе. Инженер компании это знает, а модель — нет, и спросить ей некого.
Что это не значит
Это не значит, что ИИ бесполезен в программировании. Тридцать девять процентов рабочих задач, закрытых без человека, — очень много. Это значит другое: цифра из релиза не переносится на ваш проект напрямую.
Что из этого следует на практике
Вывод довольно универсальный, и он касается не только кода.
- Проверяйте на своём. Единственный честный тест модели — ваша собственная типовая задача. Полчаса проверки скажут больше, чем любая таблица в релизе.
- Давайте контекст, который модель не может знать. Соглашения, ограничения, что трогать нельзя. Это ровно та половина условия, которой ей не хватает.
- Отличайте изолированные задачи от связанных. Написать функцию по описанию модель умеет хорошо. Вписать изменение в чужую систему — гораздо хуже.
- Считайте по итогу, а не по отдельному ответу. Если после модели правку приходится переделывать, экономии нет.
Чем полезен сам бенчмарк
Главная его ценность даже не в цифрах, а в постановке вопроса. Публичные тесты постепенно теряют смысл: их результаты попадают в обучение следующего поколения моделей, и рейтинг превращается в соревнование памяти. Тест на закрытых данных этой болезни не подвержен — до тех пор, пока данные остаются закрытыми.
Скорее всего, таких бенчмарков станет больше, и не только для кода. Проверять модели на том, чего они заведомо не видели, — единственный способ понять, что они действительно умеют.
Что такое Real-SWE?+
Бенчмарк, который проверяет модели на задачах из закрытых рабочих репозиториев реальных компаний, а не на публичном коде с GitHub.
Почему результаты вдвое ниже обычных?+
Публичный код и решения к нему модель могла видеть при обучении, а закрытый — нет. Плюс в рабочей задаче половина условия нигде не записана: её знают только инженеры компании.
Какая модель лучшая по этому тесту?+
Claude Fable 5.1 с 38,8% решённых задач, следом GPT-6 Astra (33,8%) и Gemini 3.8 Flash (31,2%).
Как выбрать модель для своей работы?+
Проверить на собственной типовой задаче и сравнить итог с учётом времени на доделки, а не ориентироваться на цифры из релиза.
Что дальше почитать
- SWE-2 от Cognition: модель для кода — про специализированные модели программирования.
- Модели для чата — что доступно и сколько стоит тысяча токенов.
Проверьте модель на своей задаче
Возьмите то, что делаете каждый день, и сравните пару моделей — это честнее любого рейтинга.
Открыть чат