Sakana MASS: модель собирает команду из своих копий и учится у неё
Японская лаборатория Sakana AI вместе с исследователями из Калифорнийского университета в Беркли опубликовала метод MASS (Multi-Agent Self-Supervision). Идея: модель работает командой из нескольких своих копий, ищет лучший способ организовать эту команду, а потом дообучается на самых удачных прогонах. Получается самоулучшение без учителя-человека и без более сильной модели.
Коротко. В MASS одна и та же модель выполняет задачи, придумывает, как распределить работу в команде, и оценивает результат. Лучшие командные прогоны становятся данными для обучения. На задачах по исследованиям в машинном обучении и анализу данных это дало заметный прирост, а в программировании результат чуть хуже исходного. Код открыт.
Как устроен MASS
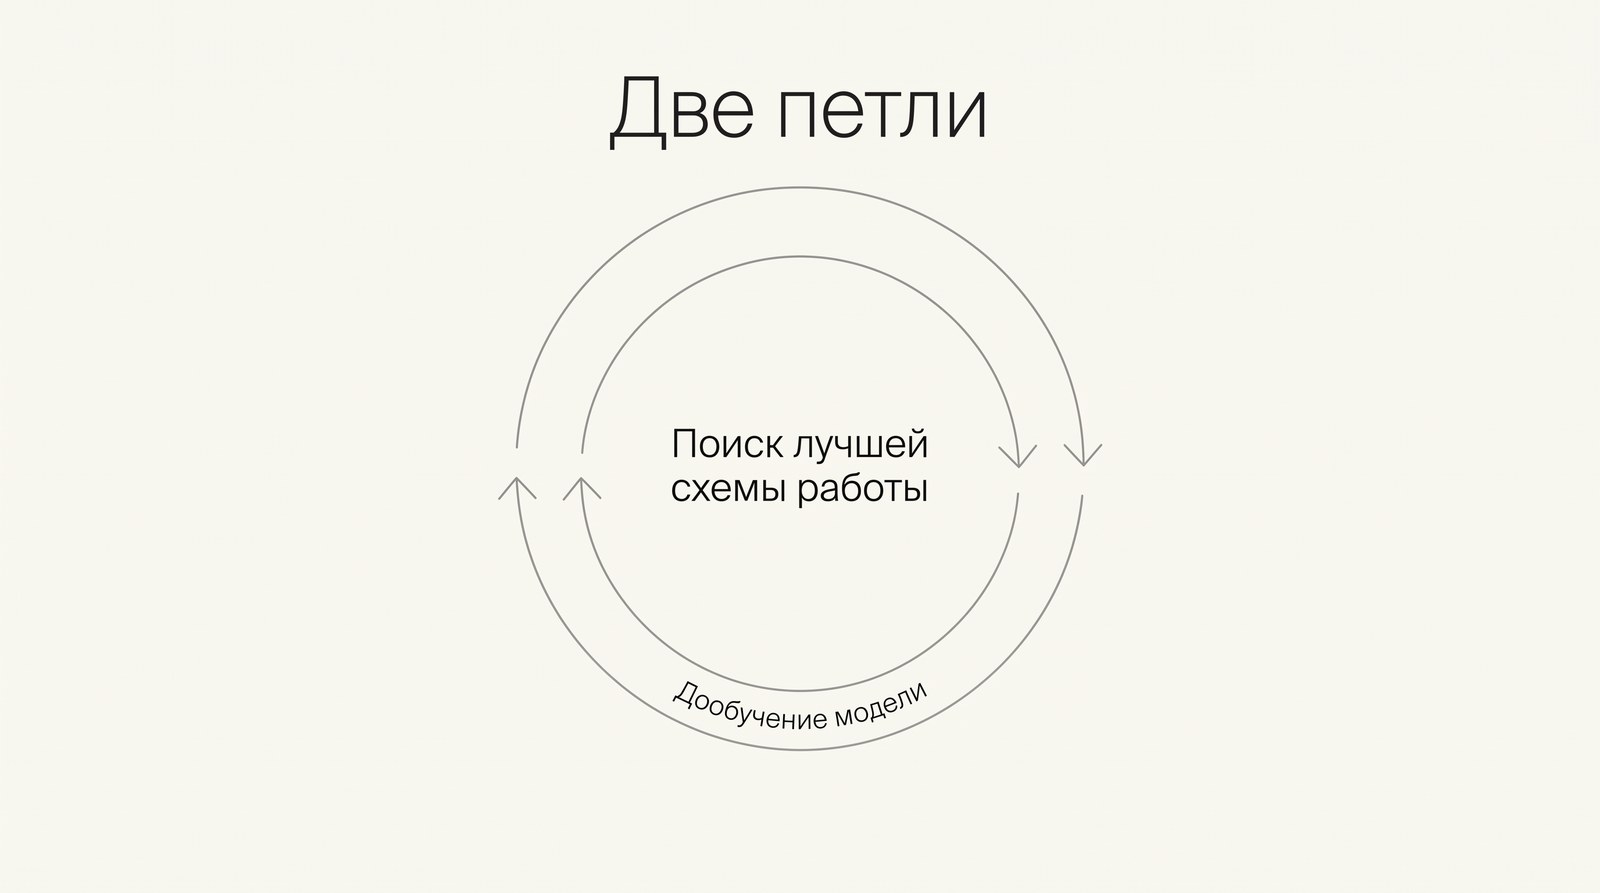
Метод состоит из двух вложенных циклов.
Внутренняя петля ищет лучшую организацию команды, веса модели в ней не меняются. Команда работает по письменному плану: какие есть роли, что каждой роли поручено, в каком виде она отдаёт результат («контракт») и в каком порядке все действуют. Модель пробует план, оценивает итог и переписывает план.
Внешняя петля берёт лучшие прогоны команды и дообучает на них общую модель. В следующем раунде уже улучшенная модель снова собирает команду, и цикл повторяется.
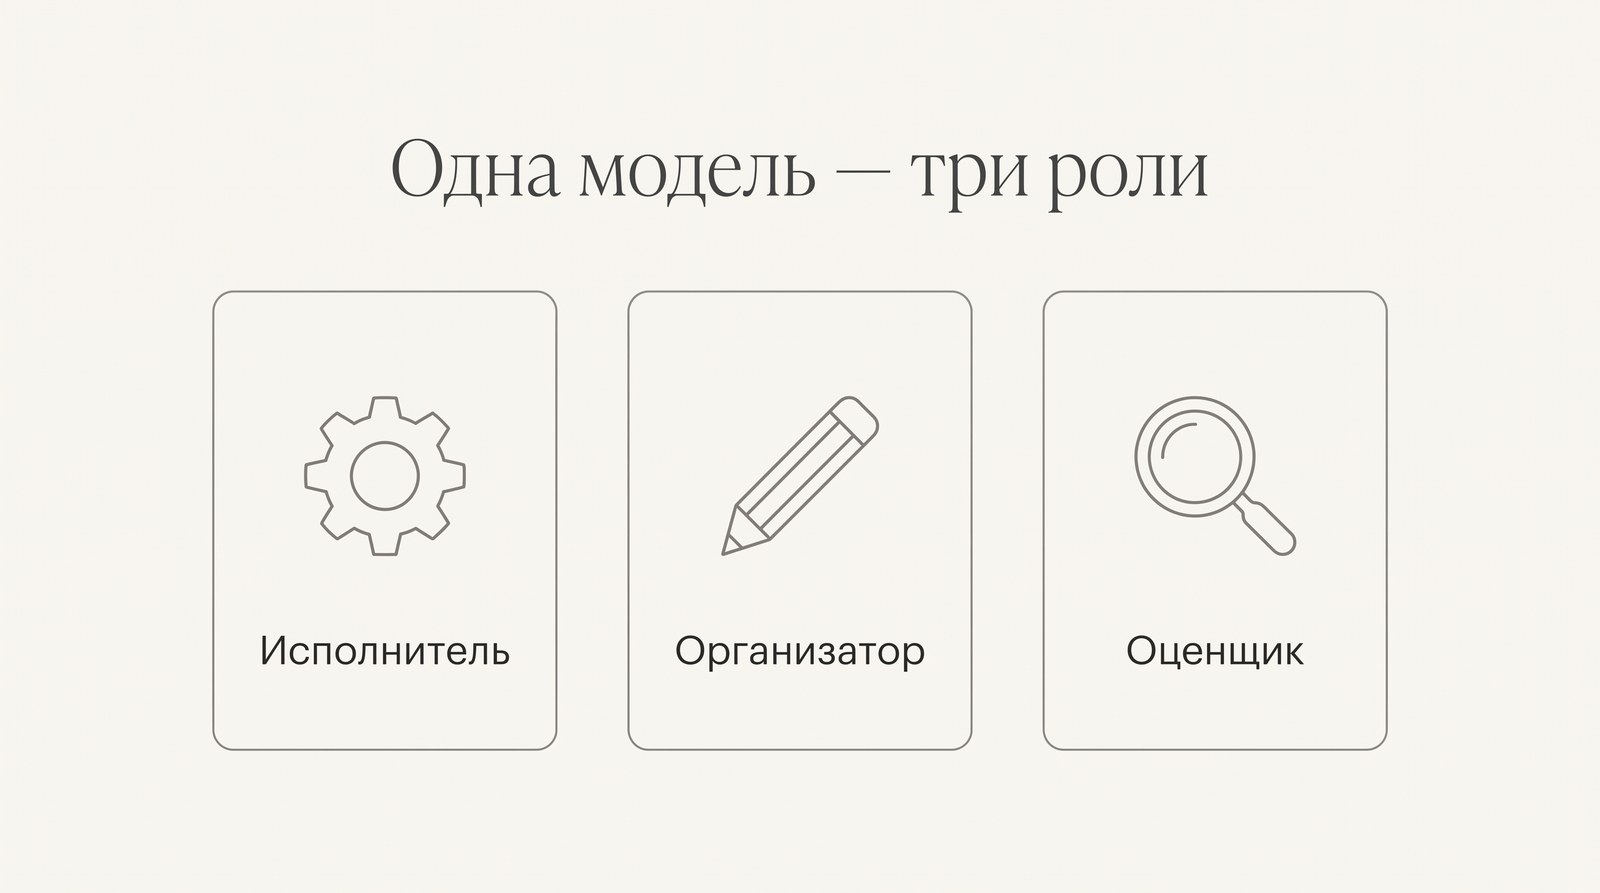
Ключевой момент: все три роли играет одна модель. Авторы называют это дистилляцией коллективного интеллекта: то, что команда копий делает лучше одиночки, переносится обратно в одну модель.
Что получилось
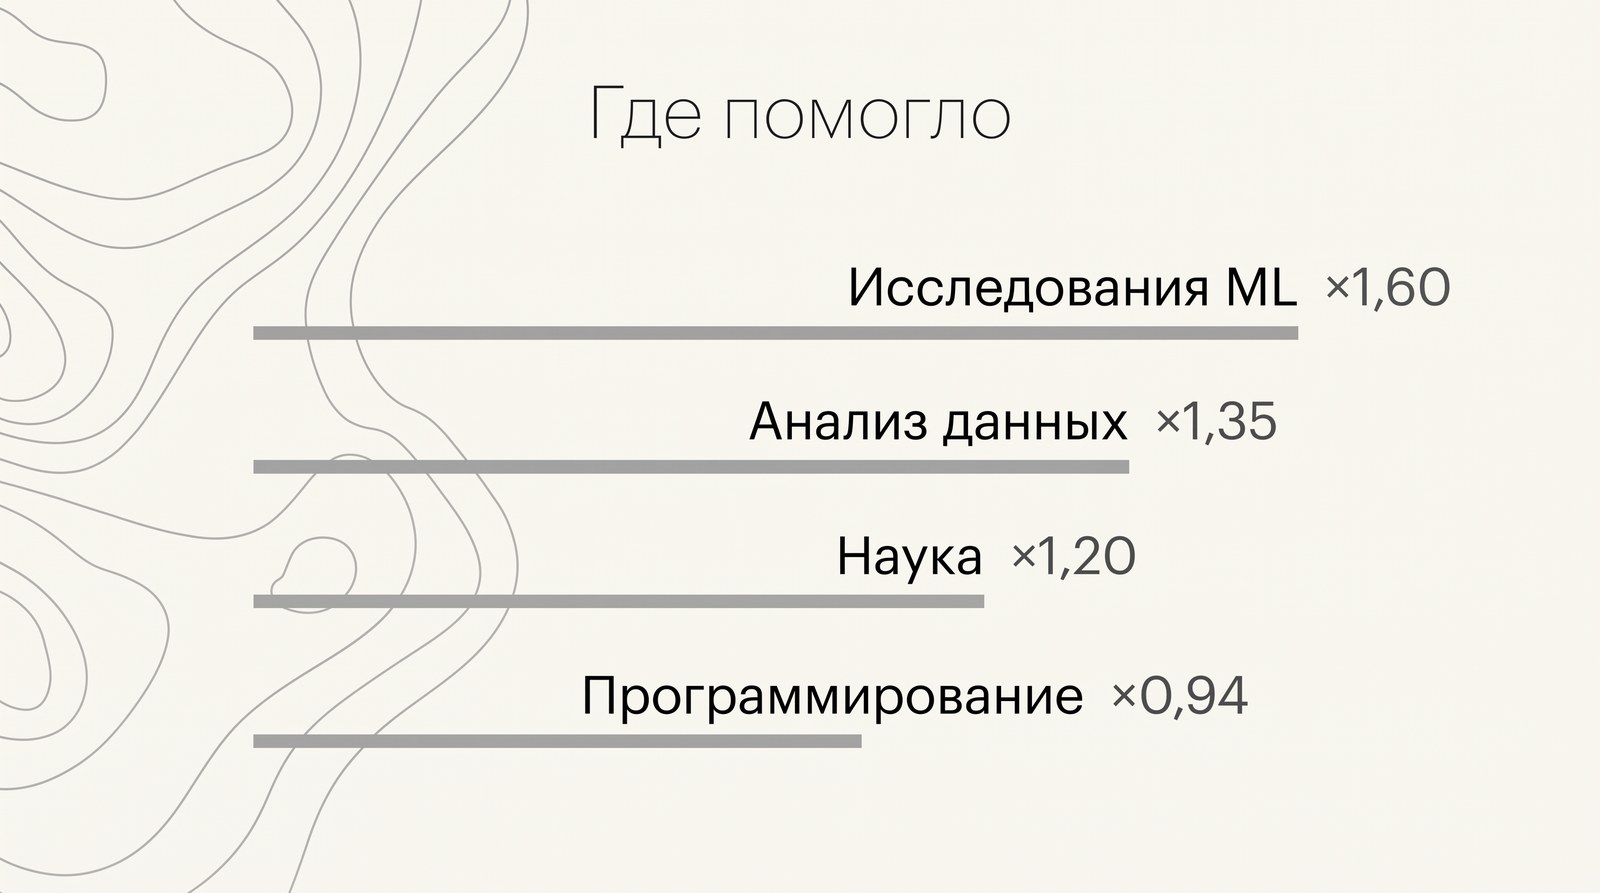
Эксперименты шли на открытой модели Qwen3.6-27B. На синтетических исследовательских задачах из финансов, робототехники и фармацевтики модель после второго раунда выигрывала у исходной в 69,9% сравнений. На публичных тестах результат такой (во сколько раз выросла оценка в пересчёте на потраченные токены):
| Тест | Что проверяет | Результат |
|---|---|---|
| MLR-Bench | исследования в машинном обучении | ×1,60 |
| DSBench | анализ данных | ×1,35 |
| AstaBench | научные задачи с агентами | ×1,28 |
| ScienceAgentBench | научные задачи | ×1,20 |
| Terminal-Bench 2.0 | работа в терминале | ×0,96 |
| SWE-bench Verified | исправление ошибок в коде | ×0,94 |
Ограничения, которые называют сами авторы
- Перенос неровный. В исследовательских задачах прирост есть, в программировании небольшой спад.
- Поиск схемы нестабилен. Бывают резкие провалы качества между итерациями.
- Общие слепые пятна. Если модель чего-то не видит, этого не увидит и её же копия в роли оценщика. Ошибка может закрепляться от раунда к раунду.
Последний пункт авторы относят и к безопасности: система, которая сама оценивает и сама учится на своих оценках, может усиливать собственные ошибки.
Что это значит на практике
Для обычного пользователя MASS пока исследование, а не продукт. Но сама идея давно работает и в чате: попросите модель разделить задачу на роли. Например, «сначала напиши черновик отчёта, потом выступи критиком и найди три слабых места, потом исправь». Это та же логика, что и в MASS, только без дообучения. О том, как устроены агенты и почему их собирают в команды, мы писали в статьях что такое ИИ-агент и оркестратор агентов от Google.
Частые вопросы
Что такое MASS от Sakana AI?+
Метод Multi-Agent Self-Supervision: модель работает командой из своих копий, улучшает схему командной работы и затем дообучается на лучших прогонах команды.
Это рекурсивное самоулучшение ИИ?+
В узком смысле да: модель улучшается на данных, которые произвела сама, без человека и без более сильной модели. Но прирост есть не везде, а авторы отдельно предупреждают, что ошибки тоже могут закрепляться.
На какой модели проверяли MASS?+
На открытой модели Qwen3.6-27B.
Можно ли попробовать MASS?+
Код выложен на GitHub (SakanaAI/mass), но для запуска нужны свои вычислительные мощности и опыт обучения моделей.
Источники: страница проекта Sakana AI, статья на arXiv, код.
Что дальше почитать
Попросите модель покритиковать саму себя
Черновик, критика, правка в одном чате на русском, без VPN.
Открыть чат