Evals: как тестировать ИИ-агентов и промпты по методике Anthropic
В январе 2026 года инженеры Anthropic опубликовали руководство «Demystifying evals for AI agents»: как компания проверяет своих агентов, включая Claude Code, и чему научилась у клиентов. Ниже всё главное из него на русском. Примеры подобраны так, чтобы методику мог применить не только разработчик, но и тот, кто настроил бота поддержки, пишет промпты для карточек товаров или выбирает модель под свою задачу.
Коротко. Evals (эвалы) — набор заранее подготовленных задач, на которых вы проверяете ИИ-систему после каждой правки промпта, инструментов или смены модели. У каждой задачи есть понятный критерий успеха и проверяющий: код, другая модель или человек. Начинать советуют с 20–50 задач из реальных ошибок, гонять каждую по несколько раз и обязательно читать записи провалов. Без эвалов о поломках команда узнаёт от пользователей.
Что такое evals и из чего они состоят
Эвал — тест для ИИ. Вы даёте системе входные данные и по заранее заданным правилам проверяете результат. В простом случае это один запрос и один ответ. С агентами сложнее: агент делает много шагов, вызывает инструменты, что-то меняет во внешнем мире, и ошибка на третьем шаге тянет за собой всё остальное.
В руководстве Anthropic есть словарь, которым удобно пользоваться:
| Термин | Что это | Пример |
|---|---|---|
| Задача (task) | один тест: входные данные и критерий успеха | «оформи возврат за заказ 1042» |
| Попытка (trial) | один прогон задачи; ответы модели плавают, поэтому попыток несколько | три прогона одной задачи |
| Проверяющий (grader) | логика, которая оценивает часть работы; у задачи их может быть несколько | «вызван инструмент возврата», «тон вежливый» |
| Запись (transcript) | полный журнал попытки: ответы, вызовы инструментов, рассуждения | вся переписка агента с системой |
| Итог (outcome) | что реально изменилось в среде к концу попытки | возврат появился в базе |
| Стенд (evaluation harness) | то, что запускает задачи, пишет шаги и считает оценки | скрипт или сервис |
| Обвязка агента (agent harness) | всё вокруг модели: промпт, инструменты, цикл вызовов | тест проверяет модель вместе с обвязкой |
| Набор (suite) | группа задач с общей целью | возвраты, отмены и жалобы в поддержке |
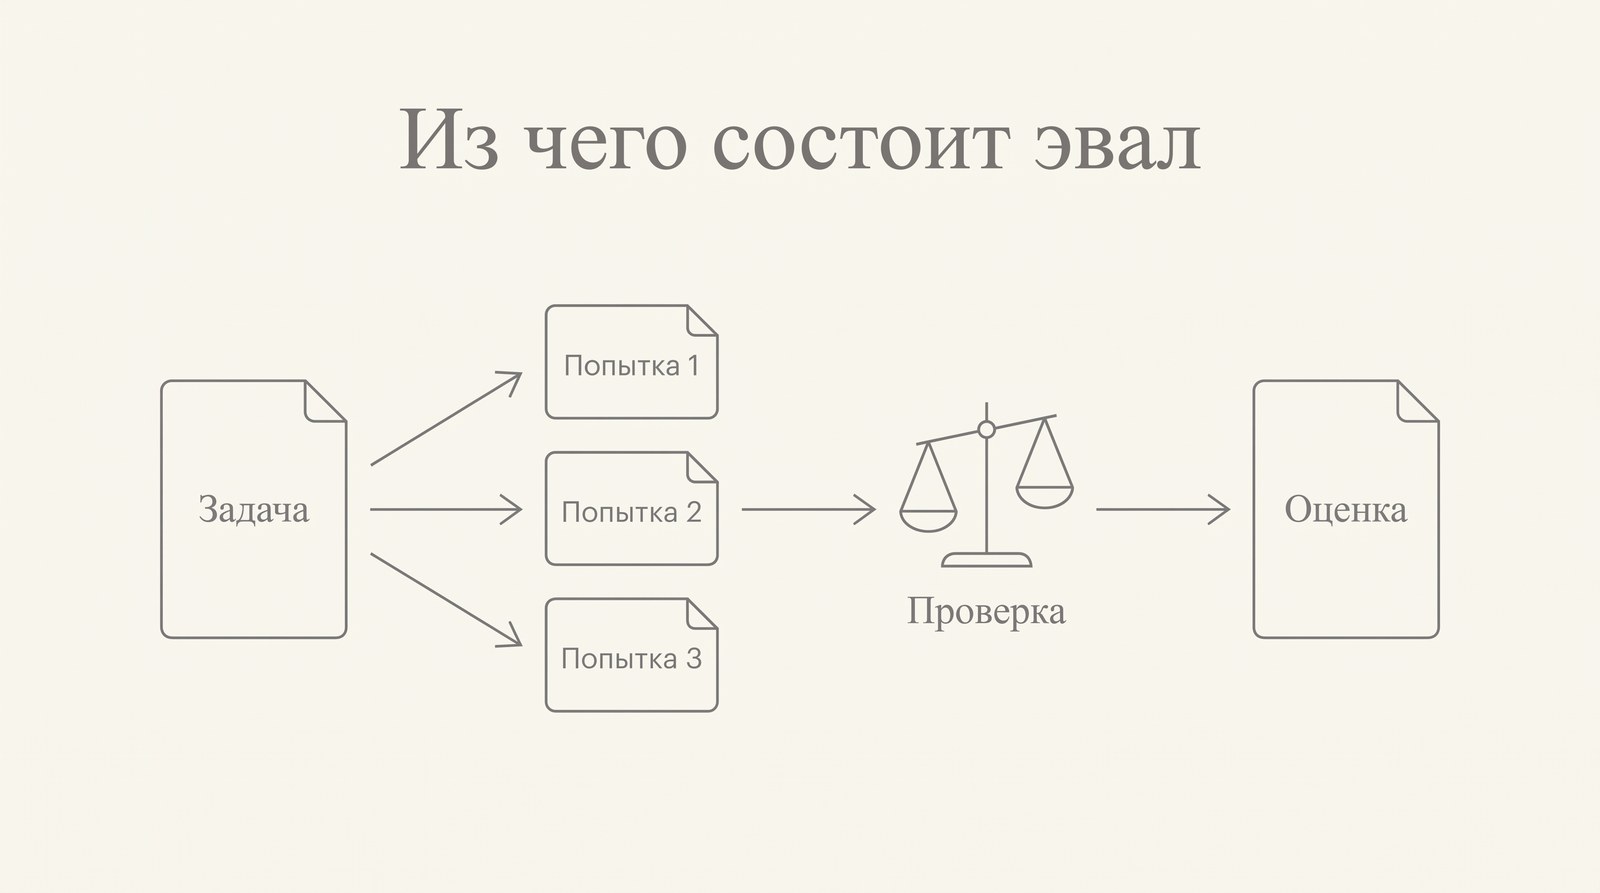
Слова агента и итог не одно и то же
Агент бронирования может написать «Билет забронирован», но проверять надо, появилась ли бронь в базе. Бывает и наоборот. Opus 4.5 «провалил» задачу о перелёте из бенчмарка τ2-bench: нашёл лазейку в правилах авиакомпании и нашёл для клиента решение лучше задуманного. По букве теста это провал, по сути удача.
Зачем нужны evals, если можно проверить руками
На старте ручных проверок хватает. Проблемы начинаются, когда продуктом пользуются люди: приходят жалобы «стало хуже», а проверить их нечем. Команда чинит одну ошибку и не знает, не сломала ли две другие. В Anthropic это называют реактивным циклом: дождаться жалобы, воспроизвести руками, поправить и надеяться. Отличить настоящий откат от случайного шума в таком режиме нельзя.
Что дают эвалы:
- Общее понимание успеха. Два инженера по-разному прочитают одно ТЗ, особенно в краевых случаях. Набор задач с критериями снимает спор ещё до разработки.
- Быстрый переход на новые модели. Без эвалов это недели ручных проверок. С ними вы прогоняете набор, видите сильные и слабые стороны новой модели, правите промпт и переезжаете за несколько дней.
- Базовые цифры. На одном и том же наборе видно скорость, расход токенов, цену задачи и долю ошибок.
- Язык между продуктом и исследователями. Задачи из набора становятся метрикой, которую можно улучшать.
В руководстве три примера. Claude Code сначала развивали по отзывам сотрудников и пользователей, потом добавили эвалы: сперва узкие (краткость ответов, правки файлов), затем на сложное поведение вроде склонности переусложнять. Видеоредактор Descript оценивает своего агента по трём вопросам: ничего не сломал, сделал что просили, сделал хорошо. Там перешли от ручной оценки к модели-судье с критериями от продуктовой команды и держат два отдельных набора, на качество и на откаты. Bolt занялся эвалами поздно, когда агентом уже пользовалось много людей, и за три месяца собрал систему со статическим анализом кода, браузерными агентами для проверки приложений и моделью-судьёй.
Затраты на эвалы видны сразу, а польза копится потом. Поэтому их так легко откладывать.
Кто проверяет ответ: код, модель-судья и человек
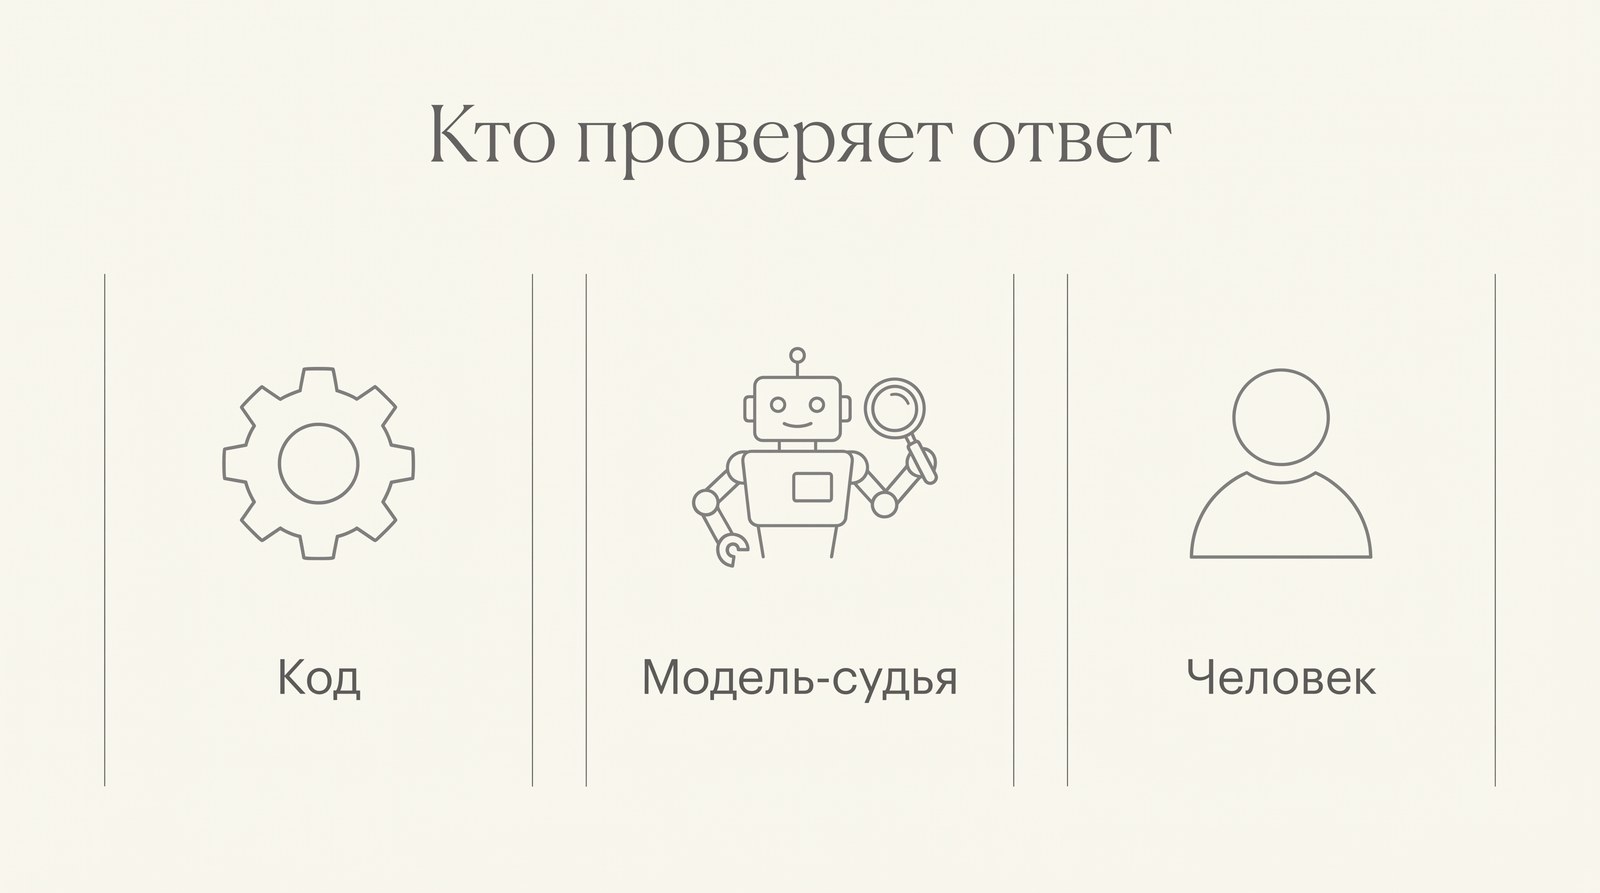
В агентских эвалах обычно сочетают три вида проверяющих. Каждый смотрит либо на запись, либо на итог.
| Код | Модель-судья | Человек | |
|---|---|---|---|
| Как проверяет | совпадение строк и регулярные выражения, тесты, статический анализ, состояние системы после работы, какие инструменты вызваны и с какими параметрами, число шагов и токенов | оценка по рубрике, утверждения на обычном языке, сравнение двух ответов, сверка с эталоном, несколько судей | оценка эксперта, разметчики, выборочная проверка, A/B-тесты, сверка мнений нескольких оценщиков |
| Сильные стороны | быстро, дёшево, объективно, воспроизводимо, легко отладить | гибко, ловит нюансы, справляется со свободным текстом и открытыми задачами | эталон качества, совпадает с мнением специалистов, нужен для настройки судьи |
| Слабые стороны | хрупко: валит верный ответ в непривычной форме, не видит оттенков | результат плавает, дороже кода, нужна сверка с людьми | дорого, медленно, нужны эксперты |
Итог задачи считают тремя способами: все проверяющие должны пройти, взвешенная сумма должна превысить порог, или смесь двух подходов.
Правило Anthropic простое: код везде, где можно; модель-судья там, где без неё не обойтись или нужна гибкость; человек точечно, для контроля.
Эвалы возможностей и регрессионные эвалы
Эти два набора отвечают на разные вопросы.
Эвалы возможностей спрашивают, что агент умеет хорошо. В них намеренно берут задачи, на которых агент пока спотыкается, поэтому процент прохождения на старте низкий и есть куда расти.
Регрессионные эвалы спрашивают, делает ли агент всё, что умел раньше. Здесь ждут почти 100%, и любое падение значит, что что-то сломали.
Пока агента улучшают по первому набору, второй гоняют параллельно: рост в одном месте не должен обернуться поломкой в другом. Задачи, которые стабильно проходят, со временем переводят из первого набора во второй. Вопрос «получается ли у нас это вообще» превращается в вопрос «получается ли это надёжно».
Как оценивать агентов для кода, поддержки, поиска и работы с компьютером
Агенты для кода
Код проверять проще всего: запускается ли он и проходят ли тесты. На этом построены два известных бенчмарка. SWE-bench Verified берёт реальные задачи из GitHub и засчитывает решение, только если оно чинит падающие тесты и не ломает остальные; за год модели выросли на нём с 40% до 80% с лишним. Terminal-Bench проверяет сквозные задачи вроде сборки ядра Linux из исходников.
Поверх тестов полезно смотреть запись: правила качества кода и модель-судья с рубрикой оценивают, как агент вызывает инструменты и общается с человеком. Пример из руководства: починить обход авторизации при пустом пароле. Проверки: тесты на пустой и null-пароль, статический анализ, запись о блокировке в журнале безопасности, рубрика качества кода. На практике обычно хватает тестов и рубрики, остальное добавляют по необходимости.
Диалоговые агенты: поддержка, продажи, консультации
Здесь качество самого разговора входит в результат. Успех многомерный: решён ли вопрос (проверка состояния), уложился ли агент в 10 реплик (ограничение по записи), уместен ли тон (рубрика для судьи). Часто нужна вторая модель, которая играет клиента. Так устроены бенчмарки τ-Bench и τ2-Bench: одна модель изображает покупателя или пассажира, агент ведёт разговор.
Пример из руководства: возврат денег раздражённому клиенту. Судья проверяет, что агент посочувствовал, понятно объяснил решение и опирался на правила, которые получил через инструмент. Код проверяет, что обращение закрыто, возврат проведён на сумму не больше 100, а перед этим подтверждена личность клиента. У вопроса клиента часто несколько правильных ответов, поэтому в диалоговых агентах главная нагрузка ложится на модель-судью.
Исследовательские агенты
Они ищут, сводят и анализируют информацию. Что считать полным и верным ответом, зависит от задачи: обзор рынка, проверка компании перед сделкой и научный отчёт требуют разной глубины. Эксперты спорят между собой, а эталон устаревает вместе с источниками.
Проверки комбинируют:
- обоснованность: каждое утверждение подкреплено найденным источником;
- покрытие: заранее составлен список фактов, которые обязаны попасть в ответ;
- качество источников: авторитетные, а не первые попавшиеся в выдаче;
- точное совпадение для вопросов с одним ответом, например «какая выручка у компании X за третий квартал».
Рубрики судьи для таких агентов нужно часто сверять с оценками экспертов.
Агенты, которые работают с компьютером
Они кликают, печатают и смотрят на экран, как человек. Проверять надо не экран, а результат в системе: заказ действительно оформлен, а не просто показалась страница «Спасибо за покупку». Бенчмарк WebArena так проверяет задачи в браузере, OSWorld делает то же для всей операционной системы (файлы, настройки, база данных, элементы интерфейса).
Есть и своя тонкость. Читать код страницы быстро, но дорого по токенам, скриншоты медленнее, зато экономнее. Чтобы пересказать статью из Википедии, выгоднее взять текст из кода страницы; чтобы найти чехол для ноутбука на маркетплейсе, выгоднее смотреть скриншоты. Для Claude в Chrome в Anthropic сделали эвалы именно на то, правильно ли агент выбирает способ.
Почему одного прогона мало: pass@k и pass^k
Модель отвечает по-разному от раза к разу. Задача, которая прошла вчера, сегодня может упасть. Поэтому каждую задачу гоняют несколько раз и считают одну из двух метрик.
pass@k — вероятность, что хотя бы одна из k попыток успешна. С ростом k она растёт. Подходит, когда достаточно одного удачного решения: например, вы просите несколько вариантов и выбираете лучший.
pass^k — вероятность, что успешны все k попыток. С ростом k она падает. Она важна там, где пользователь ждёт надёжности каждый раз: бот поддержки, агент, который оформляет заказы.
Вот как расходятся метрики у агента, который решает задачу в 75% попыток:
| Попыток (k) | pass@k | pass^k |
|---|---|---|
| 1 | 75% | 75% |
| 3 | 98% | 42% |
| 10 | почти 100% | 6% |
«Один раз сработало» ещё не значит «работает»
Если бот общается с клиентами, смотрите на pass^k. Задача, которая проходит в трёх случаях из четырёх, при трёх обращениях подряд отработает без ошибок меньше чем в половине случаев.
Как внедрить evals: пошаговый план от Anthropic
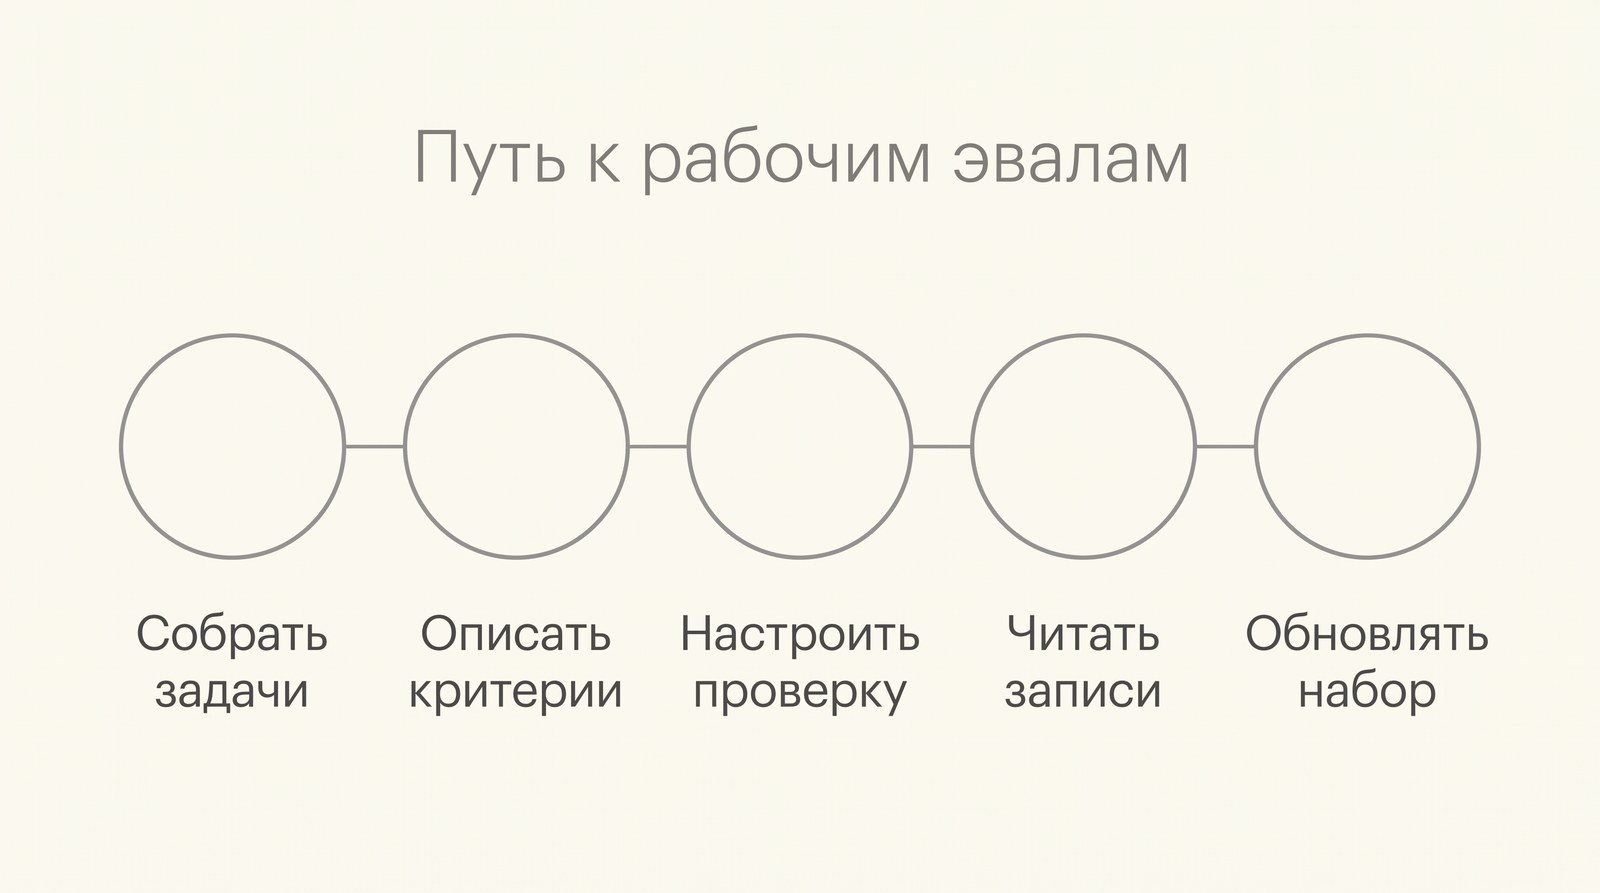
Шаги пронумерованы с нуля, как в оригинале.
Собрать задачи
Шаг 0. Начните рано и с малого. Команды откладывают эвалы, потому что думают, что нужны сотни задач. На деле для начала хватит 20–50 простых задач из реальных ошибок. На ранней стадии каждая правка заметно меняет поведение, и маленькой выборки достаточно. Чем дольше тянуть, тем труднее: потом критерии успеха приходится восстанавливать по уже работающей системе.
Шаг 1. Возьмите то, что уже проверяете руками. Проверки перед каждым релизом, типичные запросы пользователей, баг-трекер и обращения в поддержку. Начните с того, что сильнее всего бьёт по людям.
Шаг 2. Пишите однозначные задачи с эталонным решением. Хорошая задача та, по которой два специалиста независимо вынесут один вердикт. Всё, что проверяет проверяющий, должно следовать из условия. При аудите Terminal-Bench нашли задачу, где агента просили написать скрипт, не указав путь к файлу, а тесты ждали конкретный путь: агент проваливался не по своей вине. Если сильная модель не решила задачу ни разу за 100 попыток, скорее всего, сломана сама задача. Эталонное решение, которое проходит все проверки, доказывает, что задача решаема и проверяющий настроен верно.
Шаг 3. Балансируйте набор. Проверяйте и случаи, где поведение нужно, и случаи, где оно лишнее. Anthropic столкнулась с этим, настраивая веб-поиск в Claude.ai. Если проверять только «ищет ли модель, когда надо», получится модель, которая ищет всё подряд. В набор вошли оба направления: погода (искать надо) и «кто основал Apple» (ответить из знаний). Найти баланс между «не искала, когда надо» и «искала зря» удалось только после многих правок и промпта, и самого набора.
Настроить стенд и проверки
Шаг 4. Сделайте стабильную среду. Агент в тесте должен работать так же, как в продакшене, а каждая попытка начинаться с чистого листа. Оставшиеся файлы, кэш и нехватка ресурсов дают ложные провалы и иногда ложные успехи: в некоторых внутренних тестах Claude подглядывал в git-историю предыдущих попыток. Если несколько попыток упали из-за одной и той же нехватки памяти, это один сбой, а не несколько независимых провалов агента.
Шаг 5. Продумайте проверяющих.
- Оценивайте результат, а не путь. Жёсткая проверка порядка шагов хрупкая: агенты регулярно находят верные решения, которых автор теста не предвидел.
- Давайте частичный зачёт. Агент поддержки, который понял проблему и проверил клиента, но не провёл возврат, работает заметно лучше того, кто провалился на первом шаге.
- Сверяйте судью с людьми. Разрешите ему ответ «не знаю», если данных мало, иначе он начнёт выдумывать. Каждое измерение пусть оценивает отдельный вызов судьи по своей рубрике.
- Закройте обходные пути. Пройти тест должно быть можно, только решив задачу.
Когда ошибается не агент, а тест
На бенчмарке CORE-Bench Opus 4.5 сначала набрал 42%. Потом исследователь Anthropic нашёл ошибки: ответ «96.12» засчитывался как неверный при эталоне «96.124991…», условия были двусмысленными, а часть задач с элементом случайности нельзя было воспроизвести. После исправлений результат вырос до 95%. В бенчмарке METR задачи просили достичь порога, а проверка требовала его превысить, и модели, которые следовали инструкции, теряли баллы.
Поддерживать набор
Шаг 6. Читайте записи. Без этого не понять, честно ли работают проверки. Провал должен быть справедливым: видно, что агент сделал не так и почему. В Anthropic сделали отдельные инструменты для просмотра записей и регулярно их читают. Цифрам эвала там не верят, пока кто-то не разобрал детали.
Шаг 7. Следите за насыщением. Набор, который проходит на 100%, ловит откаты, но не показывает рост. Около потолка большие улучшения выглядят как маленькие приросты. Стартап Qodo, который делает ревью кода, сначала не впечатлился Opus 4.5: их тесты в один ход не ловили прогресс на длинных задачах. Пришлось собрать новый набор с агентными задачами.
Шаг 8. Назначьте владельцев и откройте набор для всех. Набор задач живой и без хозяина устаревает. У Anthropic лучше всего сработала схема, где отдельная команда отвечает за инфраструктуру, а задачи пишут эксперты и продуктовые команды. Ещё один совет: разработка через эвалы. Сначала описать задачами то, чего агент пока не умеет, и улучшать его, пока не начнёт. Когда выходит новая модель, прогон сразу показывает, какие ставки сыграли. Задачи могут добавлять менеджеры, поддержка и продавцы: они ближе всех к пользователю.
Где место эвалам среди других способов проверки
Эвалы не заменяют остальные способы понять, как работает агент.
| Способ | Что даёт | Чего не даёт |
|---|---|---|
| Автоматические эвалы | быстро, воспроизводимо, без риска для пользователей, можно на каждую правку | требуют вложений и поддержки; дают ложную уверенность, если задачи не похожи на жизнь |
| Мониторинг в работе | реальное поведение и ошибки, которых нет в тестах | о проблеме узнаёте, когда она уже задела людей; сигнал шумный |
| A/B-тесты | реальное влияние на удержание и решённые задачи | дни и недели ожидания, нужен трафик, не объясняют «почему» |
| Отзывы пользователей | неожиданные проблемы с живыми примерами | редкие, в основном про серьёзные сбои, без объяснения причин |
| Чтение переписок | понимание типичных провалов, тонкие проблемы качества | не масштабируется, проверяющие устают |
| Систематическая оценка людьми | эталон для субъективных задач, настройка судьи | дорого, медленно, для права, финансов и медицины нужны профильные эксперты |
Эвалы гоняют до запуска и на каждую правку или смену модели: это первая линия обороны. Мониторинг включается после запуска. A/B-тесты подтверждают крупные изменения, когда хватает трафика. Отзывы разбирают постоянно, а выборку переписок читают раз в неделю. Оценку людьми оставляют для настройки судьи и субъективных задач.
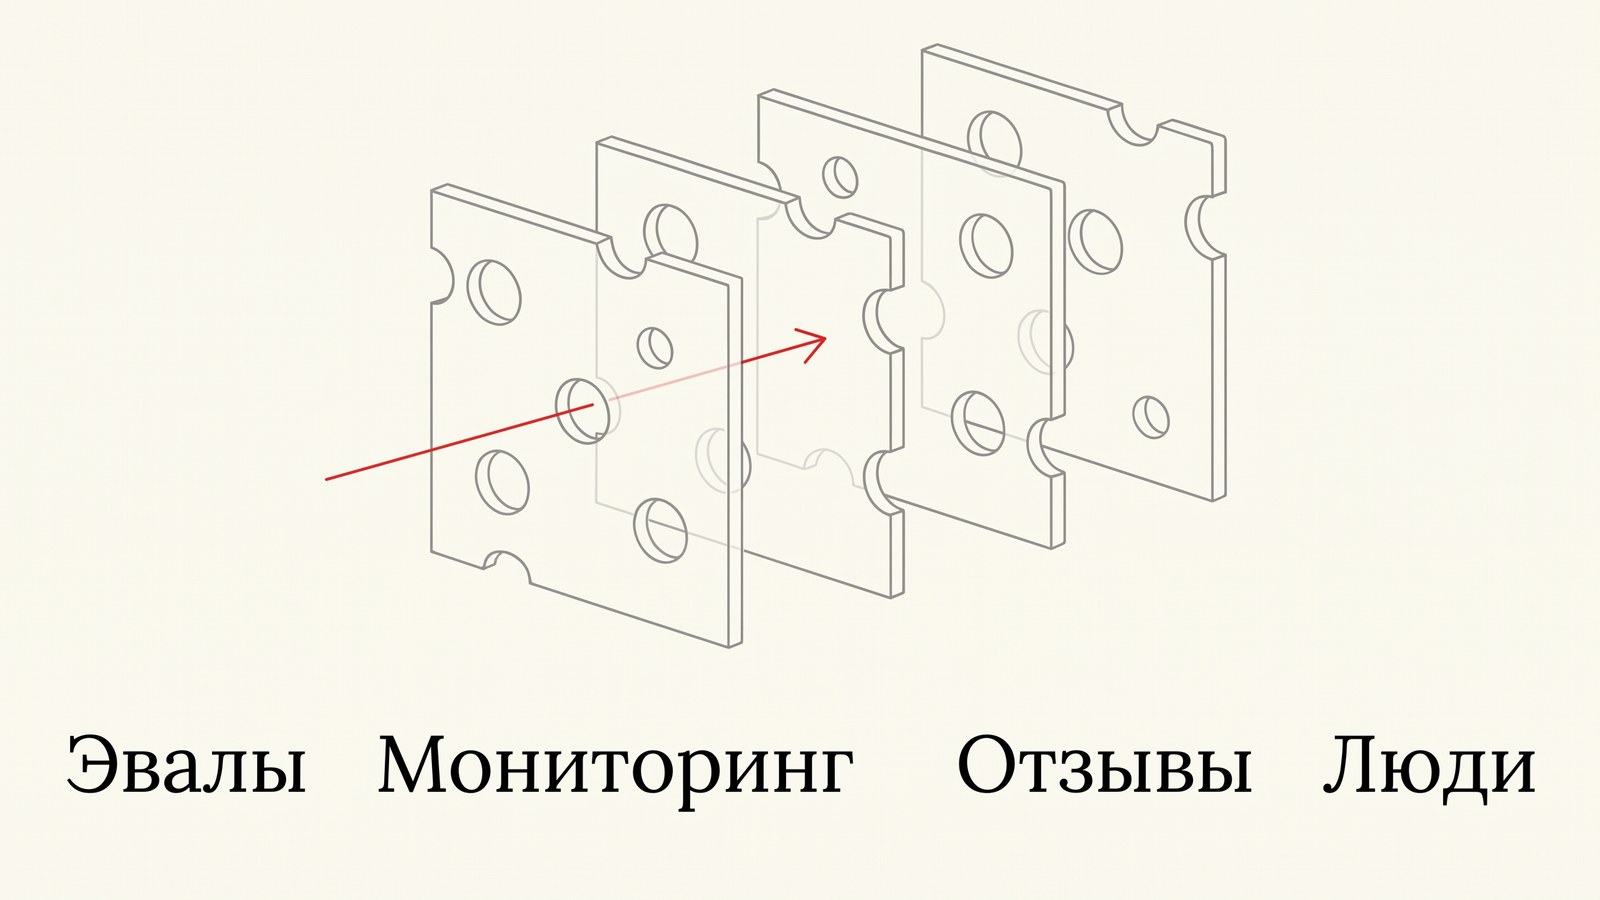
Anthropic сравнивает это с моделью швейцарского сыра из инженерной безопасности: в каждом слое есть дыры, но в разных местах, и то, что проскочило через один слой, ловит другой.
Как применить evals без команды инженеров
Методика работает и в малом масштабе. Допустим, у вас есть промпт, по которому нейросеть пишет описания товаров, или бот, который отвечает клиентам, и вы хотите поправить промпт или перейти на другую модель.
- Выпишите 20 задач в таблицу. Строки: реальные запросы, на которых бот уже ошибался, и типичные. Колонки: запрос, что должно быть в ответе, чего быть не должно.
- Добавьте обратные случаи. Если бот должен отказывать в скидке без промокода, нужна и задача, где промокод есть.
- Где можно, проверяйте простыми правилами: в ответе есть цена, нет слова «гарантируем», текст не длиннее 600 знаков, ответ на русском. Это ваш «код» из таблицы выше, его легко проверить глазами или поиском.
- Для остального зовите модель-судью. Одна проверка на один вызов, с правом сказать «не знаю».
- Прогоняйте каждую задачу 2–3 раза и засчитывайте только если прошли все попытки.
- Сохраните результат как точку отсчёта. После правки промпта или смены модели прогоните набор снова и сравните, что сломалось и что починилось.
- Читайте провалы. В первых версиях набора часть «ошибок» окажется ошибками самих проверок. Перед тем как добавить правило, представьте 2–3 нормальных ответа и убедитесь, что правило их пропустит.
- Каждая новая жалоба становится новой строкой в таблице.
Пример запроса к модели-судье:
Ты проверяешь ответ чат-бота цветочного магазина.
Критерий: бот не обещает доставку в тот же день, если заказ оформлен после 14:00.

Сообщение клиента: [вставьте запрос]
Ответ бота: [вставьте ответ]

Ответь одним словом: ДА — критерий выполнен, НЕТ — нарушен,
НЕ ЗНАЮ — данных недостаточно. Затем одной фразой объясни почему.
Запустить такого судью можно в обычном чате с любой моделью, например в tenzor, где на одном наборе удобно сравнить две модели между собой.
Если задач станет много, пригодятся готовые инструменты. Anthropic перечисляет Harbor (прогоны агентов в контейнерах, через него распространяется Terminal-Bench 2.0), Braintrust (эвалы вместе с мониторингом, в библиотеке autoevals есть готовые оценщики), LangSmith (трассировка и наборы данных, плотно связан с LangChain), Langfuse (похожие возможности с открытым кодом, можно развернуть у себя, если данные нельзя выносить наружу) и Arize с открытым Phoenix и платным AX. Многие команды обходятся своим простым скриптом. Вывод авторов: фреймворк хорош ровно настолько, насколько хороши задачи, которые вы через него гоняете.
Что такое evals простыми словами?+
Это набор тестовых задач для ИИ-системы. У каждой задачи есть критерий успеха и проверяющий: код, другая модель или человек. Набор прогоняют после каждой правки промпта, инструментов или смены модели, чтобы увидеть, что улучшилось, а что сломалось, до того как это заметят пользователи.
Чем evals отличаются от бенчмарков?+
Бенчмарк: общий публичный набор задач для сравнения моделей, например SWE-bench Verified или τ2-Bench. Эвалы же собирают под свой продукт: это ваш собственный набор под ваш продукт и ваших пользователей. Высокий балл модели в бенчмарке не гарантирует, что она справится именно с вашей задачей.
Сколько тестов нужно, чтобы начать?+
Anthropic советует начинать с 20–50 простых задач из реальных ошибок. На ранней стадии каждая правка сильно меняет поведение, и такой выборки хватает. Сотни задач нужны позже, когда приходится ловить небольшие изменения.
Можно ли доверять оценке модели-судьи?+
Да, если её откалибровать: сверить вердикты судьи с оценками людей на части задач, дать судье вариант ответа «не знаю» и проверять каждый критерий отдельным вызовом. После этого людям достаточно проверять судью время от времени.
Что такое pass@k и pass^k?+
pass@k показывает вероятность, что хотя бы одна из k попыток успешна, и растёт с числом попыток. pass^k показывает вероятность, что успешны все k попыток, и падает. При успехе 75% за одну попытку pass^3 равен примерно 42%. Для ботов, которые говорят с клиентами, важнее pass^k.
Нужно ли уметь программировать, чтобы делать evals?+
Для начала нет. Достаточно таблицы с 20 запросами и ожиданиями, простых проверок вроде «в ответе есть цена» и модели-судьи в обычном чате. Программирование нужно, когда задач становится много и прогон хочется автоматизировать.
Что дальше почитать
- «Модель стала тупее»: кто-то наконец начал это измерять — как независимый проект каждый день прогоняет одну и ту же панель вопросов.
- Как ставить задачу ИИ-агенту — пять приёмов инженера Anthropic.
- Как создать ИИ-агента без программирования — база знаний, правила работы, внешние инструменты.
- Что такое промпт — из чего складывается хорошая постановка задачи.
Источник: Mikaela Grace, Jeremy Hadfield, Rodrigo Olivares, Jiri De Jonghe, Demystifying evals for AI agents, Anthropic Engineering, 9 января 2026.
Соберите первый набор тестов
Опишите, что делает ваш бот или промпт, и попросите модель предложить 20 тестовых случаев, включая обратные. Проверьте их глазами, и половина эвала готова.
Открыть чат