OpenAI спроектировала свой чип с помощью собственных моделей
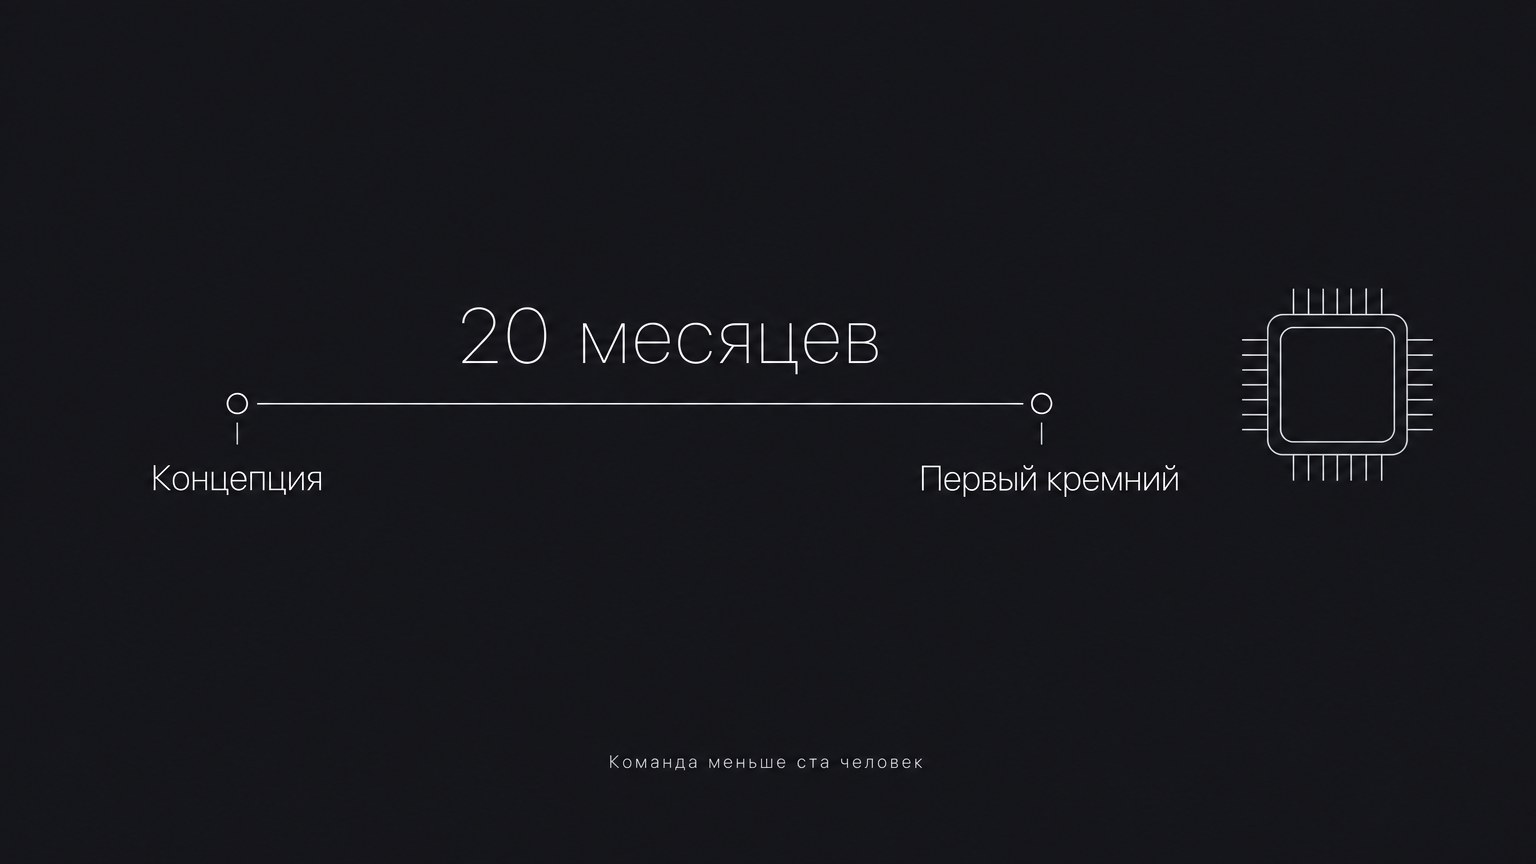
IEEE Spectrum разобрал, как создавался Jalapeño — первый собственный ускоритель OpenAI. Интересна не столько заявленная производительность, сколько сроки: от первой архитектурной концепции до первого кремния меньше двадцати месяцев, командой в среднем меньше ста человек.
Что за чип
Jalapeño выдаёт до 13,4 петафлопса в четырёхбитных вычислениях и работает с 232 гигабайтами памяти на скорости 15,4 терабайта в секунду. По замерам, на которые ссылается OpenAI, он сокращает время от запроса до последнего токена до 3,6 раза по сравнению с Nvidia GB300 и потребляет при этом меньше.
Проверить эти числа на реальной нагрузке пока нельзя: чип только идёт в парк серверов OpenAI, где будет обслуживать выдачу ответов. Ставят его стойками-подами по 2048 штук.
Где помогли нейросети
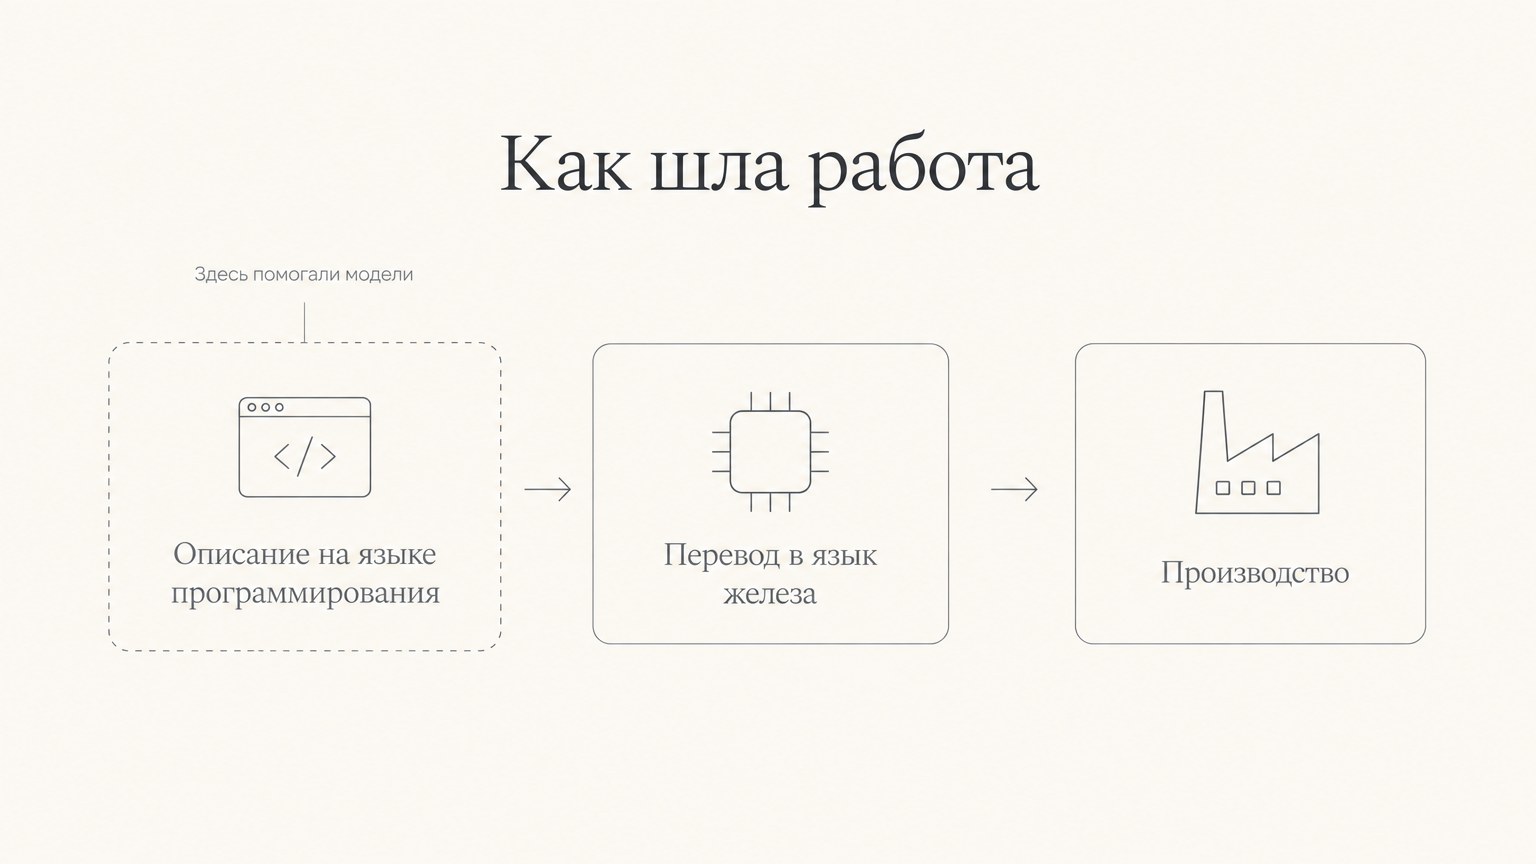
Команда сознательно взялась за ту часть работы, которая ближе всего к программированию. Логику чипа описывали не сразу на языке железа, а через высокоуровневый синтез: инженеры пишут на языке, похожем на обычный, а инструмент сам переводит это в Verilog.
«Мы думали, как ускорить проект с помощью ИИ, и ИИ заметно лучше справлялся с тем, что выглядит как программирование», — объясняет участник команды Крис Лири.
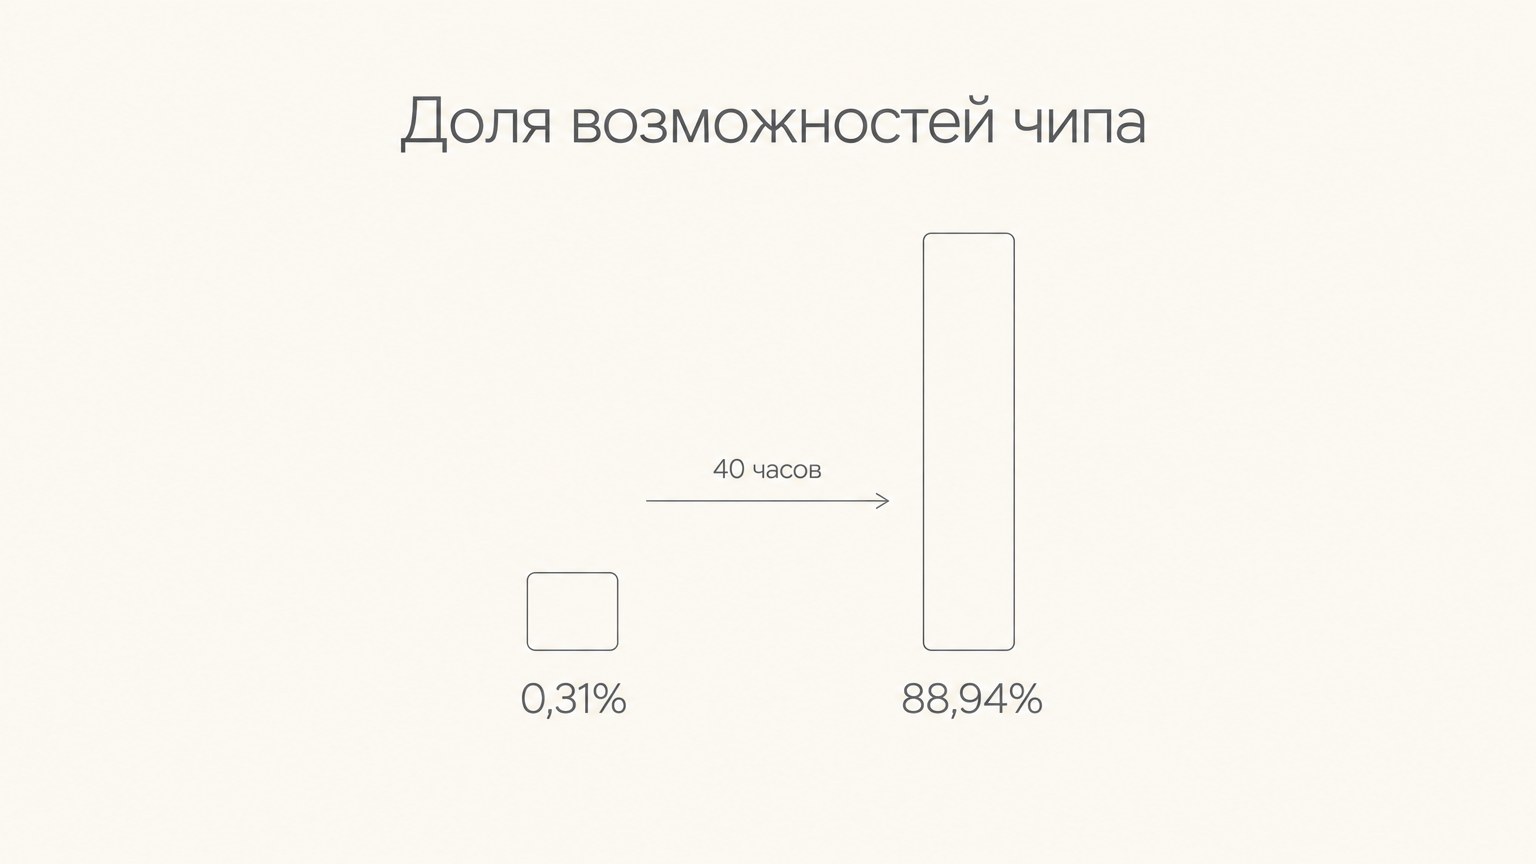
Самый выразительный результат касается софта. Когда первые чипы вернулись с завода в мае, команда направила внутренние модели на написание программ для замеров. На одном из тестов производительность выросла с 0,31% теоретического потолка до 88,94% примерно за сорок часов. По словам вице-президента по железу Ричарда Хо, результат воспроизводим, и это меняет плановые сроки между получением первых образцов и запуском серии.
Начинали проект с моделями уровня o3, закончили с предшественниками GPT-6 Astra. Разница заметна: свежие модели уже работают прямо в Verilog, без перевода с обычных языков, и почти справляются с профильными инструментами проектирования самостоятельно.
Важная оговорка: заднюю часть работы, то есть разводку, питание, подготовку данных для фабрики, вёл Broadcom. Независимые собеседники издания считают график достоверным, но подчёркивают, что без партнёра с готовой экспертизой такой скорости не вышло бы.
Почему это важно за пределами отрасли чипов
Сроки разработки железа определяют, как быстро дешевеет вычисление. Каждое новое поколение ускорителей снижает стоимость одного ответа модели, а значит, и цену, которую платит конечный пользователь. Если цикл проектирования сжимается с трёх-четырёх лет до двух, кривая удешевления становится круче.
Второй эффект — конкуренция. Пока свой чип могли позволить себе единицы, Nvidia держала рынок почти целиком. Чем доступнее проектирование, тем больше игроков со своим железом, и тем слабее зависимость цен от одного поставщика.
Третий вывод неудобный для романтиков автоматизации. Проект вела сотня инженеров, и решения принимали они. Модель ускорила перебор вариантов и написала код для замеров, но никого не заменила.
Нейросеть спроектировала чип сама?+
Нет. Модели ускорили написание кода логики и особенно софта для замеров, а инженеры оставались авторами решений. Заднюю часть проектирования вёл партнёр, Broadcom.
Насколько быстро это по меркам отрасли?+
Двадцать месяцев от концепции до кремния специалисты называют результатом уровня лучших в классе. При этом эксперты ожидают, что с новыми моделями такие сроки скоро будут выглядеть медленными.
Что за прыжок с 0,31% до 88,94%?+
Это доля теоретического потолка чипа на одном из тестовых вычислительных ядер. Модели писали и оптимизировали код замеров около сорока часов, доведя его почти до предела возможностей железа.
Подешевеют ли нейросети из-за своих чипов?+
В долгую — да, потому что стоимость ответа зависит от цены вычислений. Но выигрыш приходит не сразу: сначала чип должен попасть в серию и занять место в парке серверов.
Заменит ли ИИ инженеров-схемотехников?+
Пока картина обратная: та же сотня человек делает за двадцать месяцев то, на что раньше уходило существенно больше. Меняется не число людей, а количество вариантов, которые они успевают проверить.
Что дальше почитать
- Nvidia как центробанк ИИ — кто оплачивает вычисления, на которых работают нейросети.
- Токены и кредиты — из чего складывается цена ответа для вас.
Цена генерации видна заранее
Стоимость показывается до запуска, списывается фактическая, в рублях.
Открыть чат